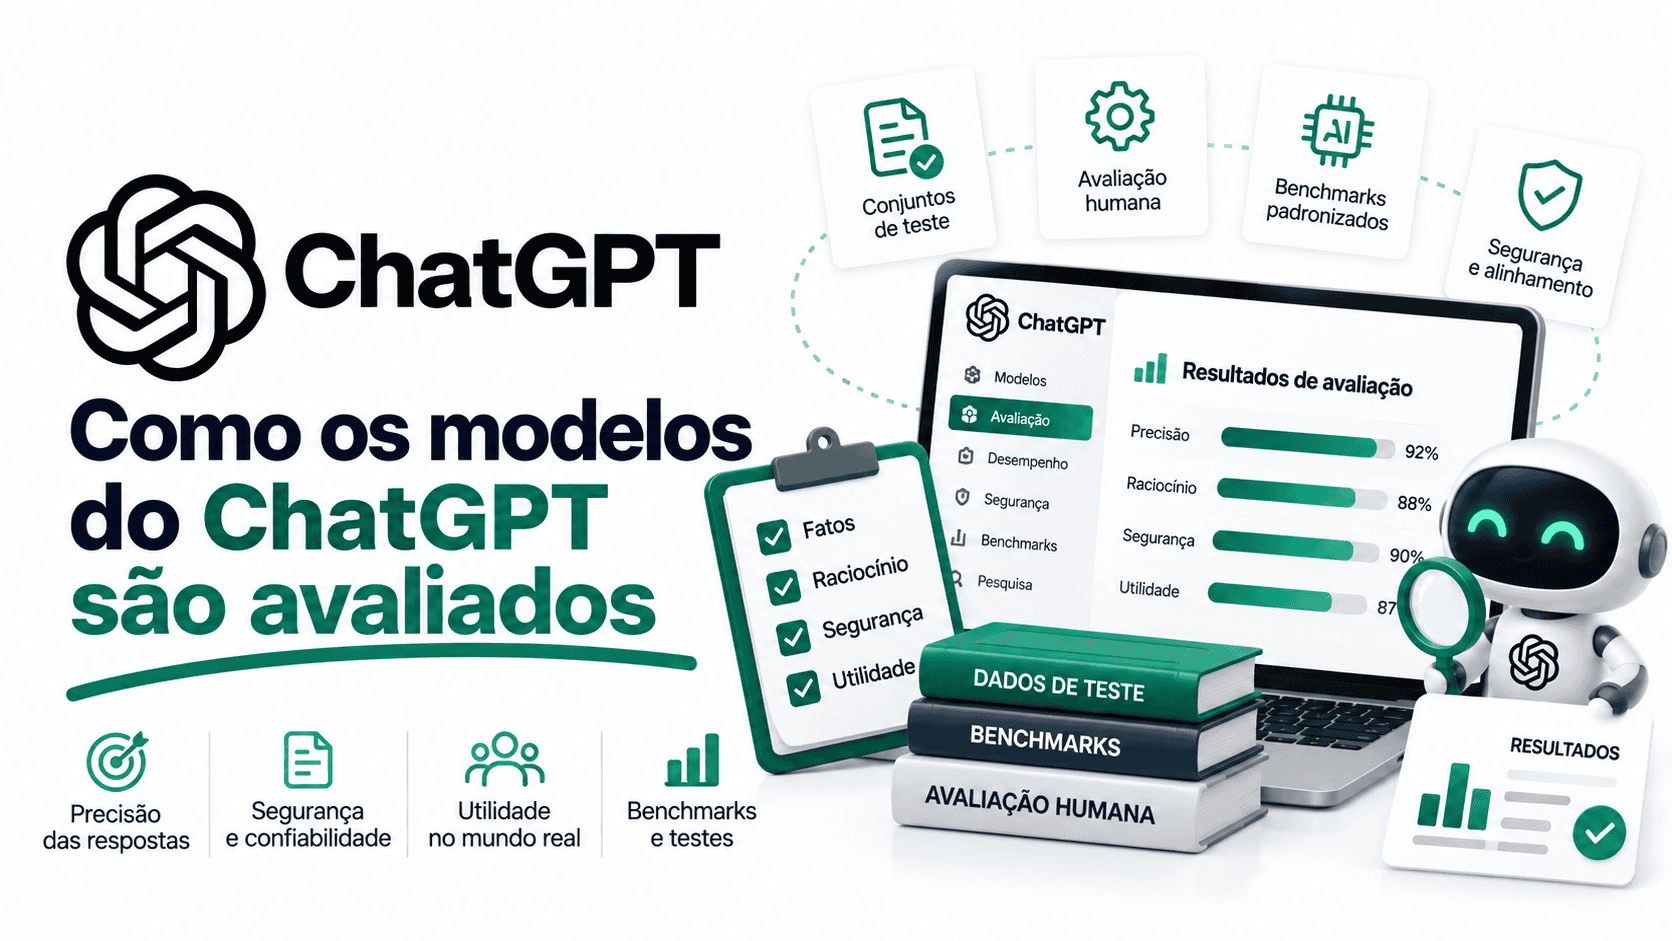

Os modelos que alimentam o ChatGPT são avaliados com uma combinação de benchmarks, testes internos, verificações automáticas, avaliações humanas, red teaming, testes de segurança e monitoramento depois do lançamento. Não existe uma única “prova do ChatGPT” capaz de resumir raciocínio, factualidade, programação, uso de ferramentas, velocidade e segurança em uma nota.
O resultado de uma avaliação só faz sentido quando você conhece as condições: qual versão do modelo foi usada, qual prompt, quais ferramentas estavam disponíveis, quantas tentativas foram permitidas, como a resposta foi corrigida e se o teste ocorreu em um ambiente de pesquisa ou no produto ChatGPT.
Um modelo não é avaliado por uma única nota: ele é testado em tarefas, ambientes, métricas e riscos diferentes.
A OpenAI descreve o desenvolvimento de seus modelos como um processo que inclui preparação de dados, pré-treinamento, pós-treinamento, avaliação e melhoria contínua após a implantação. Veja a explicação oficial sobre como o ChatGPT e os modelos fundamentais são desenvolvidos.
Métodos, produtos e documentos verificados em 12 de outubro de 2026. Modelos, ferramentas de avaliação e frameworks de segurança podem mudar.
O que significa avaliar um modelo de IA?
Avaliar um modelo significa submetê-lo a tarefas definidas e medir se suas respostas atendem a critérios previamente estabelecidos.
A pergunta avaliada pode ser objetiva, como resolver uma equação, ou aberta, como produzir uma apresentação profissional. O método de correção precisa acompanhar o tipo de tarefa.
| Tipo de tarefa | Exemplo | Forma possível de avaliação |
|---|---|---|
| Resposta factual curta | Nome, data ou número verificável | Correspondência com a resposta correta |
| Matemática | Resolver um problema | Resultado, etapas e verificação por código |
| Programação | Corrigir um repositório | Testes automatizados e revisão do patch |
| Uso de ferramenta | Consultar um sistema | Ferramenta escolhida, argumentos e resultado final |
| Texto profissional | Criar um relatório | Rubrica e avaliação humana |
| Segurança | Responder a uma solicitação perigosa | Conformidade, recusa adequada e ausência de dano |
| Agente | Concluir uma tarefa em várias etapas | Sucesso de ponta a ponta, custo, tempo e erros |
As boas práticas de avaliação da OpenAI destacam que sistemas generativos podem produzir saídas diferentes para a mesma entrada. Por isso, testes tradicionais de software não são suficientes para medir todas as formas de qualidade.
Eval, benchmark e dataset não são a mesma coisa
| Termo | Significado | Exemplo |
|---|---|---|
| Eval | Teste estruturado para medir um comportamento específico | Verificar se a resposta cita a política correta |
| Benchmark | Conjunto padronizado de tarefas e métricas usado para comparação | Uma coleção de problemas de programação |
| Dataset | Conjunto de entradas, referências e metadados | Perguntas reais de usuários com respostas revisadas |
| Test set | Parte reservada para medir desempenho | Casos que não devem orientar diretamente o ajuste |
| Ground truth | Resposta ou julgamento usado como referência | Valor confirmado em uma fonte oficial |
| Rubrica | Critérios que descrevem diferentes níveis de qualidade | Precisão, clareza, cobertura e uso de fontes |
| Grader | Mecanismo que atribui nota ou classificação | Teste de código, regra automática, modelo ou humano |
Um benchmark contém evals, mas nem toda eval precisa fazer parte de um benchmark público. Uma empresa pode criar avaliações privadas para seu produto, política e público.
Cinco camadas que podem ser avaliadas
Quando uma página informa que “o modelo alcançou determinada pontuação”, identifique qual camada foi testada.
1. Checkpoint do modelo
Um checkpoint é uma versão dos parâmetros do modelo em uma etapa do desenvolvimento. Pesquisadores podem comparar vários checkpoints antes de escolher o candidato ao lançamento.
2. Snapshot publicado
Um snapshot é uma versão identificável e estável do modelo. Ele permite comparar resultados sem depender de um alias que pode apontar para uma versão atualizada.
3. Sistema completo
O sistema pode incluir modelo, instruções, roteamento, ferramentas, filtros, recuperação de fontes e outras camadas. Uma avaliação do sistema mede mais que os pesos do modelo.
O System Card do GPT‑5, por exemplo, descreveu um sistema que combinava modelos rápidos e de raciocínio com um roteador. Esse é um exemplo de avaliação em nível de sistema, não apenas de um único model ID.
4. Produto ChatGPT
A experiência real pode incluir pesquisa na web, arquivos, análise de dados, voz, imagens, Projects, limites do plano, instruções do produto e atualizações que não estão presentes em uma chamada isolada da API.
5. Aplicação criada por uma empresa
Um chatbot empresarial inclui prompt, base de conhecimento, regras, ferramentas, interface, permissões e revisão humana. Um bom modelo pode falhar quando recebe a fonte errada ou quando a integração executa uma ação incorreta.
| Camada | O que está sendo testado | O que o resultado não prova |
|---|---|---|
| Modelo | Capacidade da versão avaliada | Qualidade de qualquer aplicativo que a utilize |
| Sistema | Modelo, ferramentas e controles juntos | Desempenho do modelo sem essas ferramentas |
| ChatGPT | Experiência do produto em determinada configuração | Resultado idêntico na API |
| Aplicação | Fluxo completo de um caso de uso | Capacidade geral em outros domínios |
Em quais etapas os modelos são avaliados?
Durante o desenvolvimento
Os pesquisadores executam avaliações em versões intermediárias para localizar falhas, comparar técnicas de treinamento e verificar se uma melhoria em uma tarefa causou uma regressão em outra.
Depois do pós-treinamento
O pós-treinamento procura alinhar o comportamento a instruções, preferências e políticas. As avaliações verificam se o modelo ficou mais útil sem aumentar erros, recusas desnecessárias ou comportamentos inseguros.
Antes do lançamento
Uma bateria de testes pode reunir benchmarks públicos, conjuntos internos, avaliação humana, red teaming, testes com ferramentas e avaliações de riscos de fronteira.
Durante o lançamento gradual
O acesso pode começar de forma limitada. A equipe acompanha falhas, incidentes, feedback e métricas antes de ampliar a disponibilidade.
Depois da implantação
Erros sinalizados por usuários, novas tentativas de ataque e mudanças no produto podem revelar casos que não estavam no conjunto original. Esses casos podem se transformar em novas evals para futuras versões.
Quais capacidades são testadas?
Factualidade
A factualidade mede se uma resposta está correta e apoiada por informações verificáveis. Um exemplo é o SimpleQA, criado para perguntas curtas com uma única resposta factual verificável.
O próprio material do SimpleQA destaca uma limitação importante: bom desempenho em perguntas factuais curtas não prova que o modelo produzirá um relatório longo sem erros. Um texto extenso pode conter dezenas de afirmações que precisam ser verificadas separadamente.
Calibração e abstenção
Um sistema bem calibrado deve demonstrar menos confiança quando tem maior probabilidade de errar. Também precisa saber quando não há informação suficiente para responder.
Uma avaliação pode distinguir:
- resposta correta;
- resposta incorreta;
- abstenção adequada;
- resposta confiante sem evidência.
Isso evita premiar um modelo apenas por tentar responder a todas as perguntas.
Raciocínio matemático e científico
Essas avaliações medem resultado, método, capacidade de lidar com ambiguidade e, em alguns casos, uso de ferramentas. Uma resposta final correta pode ter vindo de um raciocínio inválido, por isso o desenho do teste importa.
Programação
Testes de programação podem ir de uma função pequena à resolução de um issue em um repositório. A forma mais forte de correção costuma executar o código e verificar testes, em vez de avaliar apenas se o patch parece correto.
A página OpenAI Evals reúne exemplos como SWE-Lancer e PaperBench, que procuram aproximar a avaliação de tarefas reais de engenharia e pesquisa.
Uso de ferramentas
Uma avaliação de ferramentas pode verificar:
- se a ferramenta correta foi escolhida;
- se os argumentos estavam corretos;
- se a resposta foi interpretada corretamente;
- se a tarefa foi concluída;
- se uma ação perigosa foi bloqueada;
- se houve confirmação antes de uma ação externa.
Trabalho profissional
Avaliações de trabalho real usam entregáveis, rubricas e profissionais do setor. Elas podem medir a qualidade de uma planilha, apresentação, análise jurídica, relatório financeiro ou recomendação operacional.
O GDPval, apresentado no portal de evals da OpenAI, utiliza tarefas ligadas a ocupações e avalia a qualidade dos entregáveis. Esse tipo de teste é mais próximo do trabalho profissional que uma prova de múltipla escolha, mas continua limitado pelas tarefas e rubricas escolhidas.
Visão, áudio e multimodalidade
Modelos multimodais exigem conjuntos específicos para imagens, gráficos, áudio, voz e combinação de modalidades. Um resultado em texto não demonstra qualidade de voz, e uma boa descrição de imagem não comprova precisão em documentos escaneados.
Desempenho multilíngue
Avaliações em inglês não garantem o mesmo desempenho em português do Brasil. Idioma, variedade regional, vocabulário técnico e contexto cultural precisam aparecer nos testes.
O System Card do GPT‑4o documentou avaliações multilíngues e também reconheceu lacunas entre idiomas. Para um produto brasileiro, isso reforça a necessidade de um conjunto próprio em PT-BR.
Como as respostas recebem uma nota?
O método de correção é chamado de grader. Nenhum grader é ideal para todas as tarefas.
| Grader | Uso adequado | Limite |
|---|---|---|
| Correspondência exata | Resposta curta com formato único | Pune respostas equivalentes com outra redação |
| Verificação de texto | Presença de termo ou estrutura | Não mede veracidade |
| Similaridade | Comparação semântica | Pode premiar texto parecido, mas errado |
| Teste em Python | Cálculo, código e regra determinística | Exige comportamento formalizável |
| Rubrica | Resposta aberta e entregável profissional | Depende da qualidade dos critérios |
| Modelo avaliador | Grande volume de respostas abertas | Pode reproduzir vieses e preferências |
| Avaliador humano | Nuance, utilidade e qualidade profissional | Possui custo, variação e divergência |
A documentação de graders da OpenAI descreve verificações de string, similaridade, execução de Python e graders baseados em modelo. Ela também recomenda validar o grader contra exemplos avaliados por humanos.
Um modelo pode avaliar outro modelo?
Sim. Um modelo avaliador pode aplicar uma rubrica a milhares de respostas. Isso permite escalar testes que seriam caros para avaliadores humanos.
O grader também pode errar, preferir determinado estilo, ser influenciado pela ordem das respostas ou deixar de identificar uma falha técnica. Por isso, ele deve ser comparado com julgamentos humanos confiáveis e testado em casos difíceis.
O modelo pode avaliar a própria resposta?
Pode realizar uma revisão, mas isso não cria uma confirmação independente. O mesmo modelo pode manter a premissa errada que produziu o primeiro erro.
Para afirmações importantes, use uma fonte externa, um teste determinístico ou revisão humana especializada.
Como interpretar as métricas mais comuns
| Métrica | O que mede | Cuidado |
|---|---|---|
| Accuracy | Proporção de respostas classificadas como corretas | Depende da definição de correto |
| Exact match | Correspondência literal com a referência | Pode rejeitar resposta equivalente |
| Pass@1 | Sucesso na primeira tentativa | É mais próximo de uma resposta única |
| Pass@k | Probabilidade de ao menos uma tentativa funcionar entre várias | Não representa uma única execução |
| Rubric score | Pontos obtidos em vários critérios | O peso dos critérios muda o resultado |
| Win rate | Frequência com que uma saída é preferida a outra | Preferência não é factualidade |
| Elo | Ranking relativo derivado de comparações | Depende dos participantes e confrontos |
| Error rate | Proporção de falhas | É preciso definir a gravidade |
| Abstenção | Frequência com que o modelo não tenta responder | Pode ser prudência ou recusa excessiva |
| Latência | Tempo para produzir o resultado | Pode mudar com ferramentas e carga |
| Custo por tarefa | Custo total até concluir o trabalho | Inclua retries, ferramentas e revisão |
Pass@1 e pass@k podem contar histórias diferentes
Um modelo pode obter uma boa pontuação quando recebe várias tentativas, mas falhar com frequência na primeira execução. Para um assistente que responde uma vez ao cliente, pass@1 costuma ser mais relevante.
Em um fluxo que gera várias soluções e usa um verificador confiável para selecionar uma delas, pass@k pode ser útil. A seleção também adiciona custo e precisa funcionar sem acesso à resposta correta.
Oracle@k não é a experiência de um usuário comum
Uma métrica oracle escolhe a melhor tentativa depois de conhecer o desempenho real de cada uma. Ela mostra um limite de potencial, mas não informa se o sistema consegue selecionar a melhor resposta sozinho.
Como a segurança é avaliada?
A segurança exige conjuntos diferentes dos testes de capacidade. Um modelo pode ser competente em programação e, ao mesmo tempo, exigir controles adicionais para solicitações perigosas.
As avaliações podem verificar:
- produção de conteúdo proibido;
- resistência a jailbreaks;
- recusa de solicitações perigosas;
- recusa indevida de pedidos legítimos;
- vieses e tratamento desigual;
- inferências sensíveis sem fundamento;
- proteção de informações privadas;
- uso inseguro de ferramentas;
- capacidades cibernéticas ou biológicas de maior risco;
- autonomia em tarefas longas.
Red teaming
No red teaming, especialistas tentam encontrar falhas de forma aberta e adversarial. Eles não recebem apenas perguntas de um dataset fixo; procuram estratégias novas, combinações incomuns e maneiras de contornar as proteções.
O System Card do GPT‑4o descreve red teaming externo, classificação manual e graders automáticos. Descobertas abertas também podem ser transformadas em avaliações quantitativas repetíveis.
Red teaming amplia a cobertura, mas não prova ausência de risco. O resultado depende das áreas investigadas, da versão testada, dos especialistas e do tempo disponível.
Preparedness Framework
O Preparedness Framework da OpenAI descreve como a empresa acompanha capacidades avançadas que podem gerar danos graves e quais salvaguardas devem existir.
O processo distingue capacidade do modelo e proteção do sistema. Um modelo pode demonstrar uma capacidade de risco antes das mitigações, enquanto a decisão de implantação considera o resultado após salvaguardas.
System Cards
System Cards documentam partes do processo de segurança, os modelos testados, as métricas, os riscos observados e as mitigações.
Elas são fontes importantes, mas permanecem documentos publicados pela própria OpenAI. Quando o risco ou a decisão exige independência, procure também avaliações externas, estudos reproduzíveis e testes próprios.
Por que um benchmark não reproduz automaticamente o ChatGPT?
O mesmo nome de modelo pode produzir resultados diferentes quando a configuração muda.
| Variável | Como pode alterar o resultado |
|---|---|
| Snapshot | Versões diferentes podem conter ajustes distintos |
| Prompt | Instruções e exemplos mudam o comportamento |
| Reasoning effort | Mais processamento pode melhorar tarefas difíceis, com custo e latência maiores |
| Ferramentas | Web, terminal, Python ou arquivos adicionam capacidades |
| Contexto | Mais ou menos informação altera o que o modelo consegue usar |
| Número de tentativas | Várias amostras aumentam a chance de uma resposta correta |
| Ambiente | Permissões, sistema operacional e software afetam agentes |
| Tempo limite | Uma tarefa longa pode falhar por falta de tempo |
| Grader | Critérios diferentes atribuem notas diferentes |
| Camada de produto | Roteamento, filtros e instruções podem mudar a saída |
As notas de rodapé podem mudar a interpretação
A página de lançamento do GPT‑5.5 é um exemplo útil. Ela informa que determinadas evals foram executadas com esforço de raciocínio xhigh em um ambiente de pesquisa e que os resultados podem diferir do ChatGPT em produção.
A mesma página registra indícios de memorização em uma avaliação de programação. Sem ler essa observação, o leitor poderia interpretar a pontuação como uma medida limpa e universal.
Não copie apenas o número principal. Leia modelo, configuração, ferramentas, métrica, versão, amostra e notas de rodapé.
Principais limites dos benchmarks
Escopo estreito
Um benchmark pode medir perguntas factuais curtas, mas não relatórios; ou medir código em repositórios públicos, mas não a arquitetura privada da sua empresa.
Contaminação e memorização
Se exemplos ou soluções aparecem nos dados de treinamento, o modelo pode ter aprendido partes do teste. Isso dificulta separar capacidade de generalização e lembrança do material.
Saturação
Quando muitos modelos se aproximam do máximo, o benchmark deixa de distinguir melhorias importantes. Também pode incentivar otimização para uma prova que já não representa os problemas atuais.
Diferenças de configuração
Comparar um modelo com navegador, terminal e várias tentativas contra outro sem ferramentas e com uma tentativa não é uma comparação controlada.
Viés do grader
Um grader baseado em modelo pode preferir respostas mais longas, um estilo específico ou determinada estrutura. Um avaliador humano também pode divergir de outro.
Idiomas e populações sub-representados
Uma média multilíngue pode esconder baixo desempenho em português do Brasil ou em um setor específico. Analise os resultados por idioma, domínio e grupo de usuários.
Conjuntos internos
Uma avaliação interna pode conter tarefas mais atuais e realistas. Por outro lado, o público pode não conseguir inspecionar o dataset, repetir o teste ou verificar a correção.
Como ler uma tabela de benchmark
- Identifique o modelo: nome, model ID, snapshot e data.
- Defina a camada: modelo, agente, sistema, ChatGPT ou aplicação.
- Leia a tarefa: o que o benchmark realmente pede.
- Confira a versão: benchmarks podem mudar de dataset e regras.
- Entenda a métrica: accuracy, pass@1, pass@k, Elo ou rubrica não são equivalentes.
- Verifique as ferramentas: navegador, terminal, Python, arquivos e busca.
- Veja o esforço: configuração de raciocínio e orçamento de tokens.
- Conte as tentativas: uma resposta ou dezenas de amostras.
- Leia o ambiente: sistema operacional, permissões, software e tempo.
- Identifique o grader: teste, humano ou modelo.
- Procure limitações: contaminação, amostra pequena e tarefas privadas.
- Compare custo e latência: não apenas qualidade.
- Verifique a relevância: a tarefa se parece com seu uso?
Exemplo: 81% é realmente melhor que 78%?
Imagine dois modelos em um benchmark de programação:
Modelo A: 81%
Modelo B: 78%
Antes de escolher o Modelo A, você precisa saber:
- os dois usaram o mesmo dataset?
- a métrica foi pass@1?
- quantas tentativas foram permitidas?
- ambos tiveram terminal e internet?
- o orçamento de tokens foi igual?
- o Modelo A custou muito mais?
- a diferença permanece em diferentes linguagens?
- os erros do Modelo A são mais perigosos?
- a amostra é grande o suficiente?
- o benchmark se parece com sua base de código?
O número maior é um sinal, não uma decisão completa.
Como uma empresa deve avaliar um modelo para seu próprio uso?
O benchmark mais útil é aquele que reproduz o trabalho, os dados, as regras e os erros relevantes para sua aplicação.
- Defina a tarefa: descreva exatamente o que entra e o que deve sair.
- Defina o custo de falha: um erro de pontuação é diferente de um erro médico.
- Colete exemplos reais: remova dados pessoais e informações desnecessárias.
- Inclua casos difíceis: ambiguidade, ausência de fonte, conflito e tentativa de manipulação.
- Reserve um conjunto de teste: não ajuste continuamente o sistema nos mesmos casos usados para medir.
- Escreva a rubrica: declare o que é correto, aceitável e perigoso.
- Escolha graders: combine regras automáticas, testes, modelos e humanos.
- Calibre o grader: compare-o com avaliações humanas revisadas.
- Fixe a configuração: modelo, snapshot, prompt, ferramentas e parâmetros.
- Execute mais de uma amostra: quando a variabilidade for relevante.
- Analise os erros: não olhe somente a média.
- Meça custo e latência: inclua retries e revisão humana.
- Teste regressões: execute o conjunto novamente antes de cada mudança.
- Use shadow mode: compare o novo sistema sem substituir o fluxo oficial.
- Monitore produção: transforme falhas reais em novas evals.
Exemplo de eval para um assistente de atendimento
Considere um assistente que responde perguntas sobre a política de troca de uma loja.
Dataset de teste
- cliente pergunta o prazo normal;
- produto pertence a uma categoria excluída;
- a política não contém a resposta;
- duas versões da política estão disponíveis;
- cliente pede uma exceção;
- o documento contém uma instrução maliciosa;
- cliente envia dado pessoal desnecessário;
- a pergunta está fora do escopo.
Critérios
| Critério | Comportamento esperado |
|---|---|
| Factualidade | Usar somente a política vigente |
| Fonte | Indicar a seção correta |
| Ausência de resposta | Não inventar e encaminhar para atendimento |
| Privacidade | Não repetir dado pessoal desnecessário |
| Segurança | Ignorar instrução maliciosa no documento |
| Tom | Ser claro sem prometer uma exceção |
| Escalonamento | Encaminhar casos que exigem decisão humana |
| Latência | Responder dentro do limite operacional |
Um benchmark geral de conhecimento não mede essa política, esse risco de privacidade ou esse processo de encaminhamento. Por isso, a empresa precisa de evals próprias.
Prompt para criar uma primeira eval
Ajude-me a planejar uma avaliação para este sistema de IA.

Caso de uso:
[descreva a tarefa]

Usuários:
[quem utiliza]

Entrada:
[dados recebidos]

Saída esperada:
[resultado]

Riscos:
[erros mais importantes]

Crie:
1. definição de sucesso;
2. categorias de casos;
3. exemplos normais;
4. casos ambíguos;
5. casos sem resposta;
6. casos adversariais;
7. rubrica;
8. métricas;
9. graders adequados;
10. pontos que exigem revisão humana;
11. critérios de aprovação;
12. critérios de interrupção.

Não invente dados da empresa.
Diferencie o que pode ser verificado automaticamente do que exige julgamento humano.
Inclua custo, latência, segurança e regressões.
Prompt para analisar uma tabela de benchmark
Analise esta tabela de benchmark sem declarar um vencedor automático.

Para cada resultado, identifique:
- modelo e snapshot;
- data;
- versão do benchmark;
- tarefa;
- métrica;
- número de tentativas;
- ferramentas disponíveis;
- reasoning effort;
- contexto;
- ambiente;
- tempo limite;
- grader;
- custo;
- latência;
- limitações;
- sinais de contaminação ou memorização;
- relevância para meu caso.

Depois, separe:
1. comparações válidas;
2. comparações não equivalentes;
3. informações ausentes;
4. conclusões sustentadas;
5. conclusões que não podem ser feitas.

Não use a maior pontuação como único critério.
OpenAI Evals e a mudança atual da plataforma
O termo evals continua descrevendo a metodologia de testar sistemas de IA. Entretanto, a ferramenta chamada OpenAI Evals está em processo de descontinuação.
A página oficial de depreciações da OpenAI API informa que a depreciação foi anunciada em 3 de junho de 2026. As evals existentes devem ficar somente para leitura em 31 de outubro de 2026, e o dashboard e a API estão programados para encerrar em 30 de novembro de 2026.
Isso não torna as avaliações menos importantes. Para projetos novos, mantenha datasets, prompts, rubricas, resultados e testes em um processo versionado que possa continuar mesmo quando uma ferramenta específica for substituída.
É possível reproduzir as avaliações da OpenAI?
Algumas avaliações são públicas e podem ser executadas por terceiros. Outras dependem de:
- dataset privado;
- infraestrutura interna;
- ferramentas não publicadas;
- model snapshot sem acesso externo;
- avaliadores contratados;
- ambiente de pesquisa específico;
- rubrica proprietária.
Quando a reprodução completa não é possível, verifique se a metodologia informa exemplos, configuração, métrica, amostra, baseline e limitações.
Erros comuns ao comparar avaliações
- Comparar pass@1 de um modelo com pass@8 de outro.
- Comparar um agente com ferramentas a um modelo sem ferramentas.
- Ignorar o esforço de raciocínio.
- Usar o resultado de uma versão antiga do benchmark.
- Tratar preferência humana como precisão factual.
- Ignorar custo e latência.
- Aplicar um resultado em inglês ao português sem teste.
- Considerar uma média sem analisar categorias.
- Transferir resultado da API para o ChatGPT.
- Ignorar as notas de rodapé.
- Usar um benchmark público como único teste de produção.
- Escolher um modelo apenas porque é mais novo.
Checklist antes de escolher um modelo
- Minha tarefa aparece no benchmark?
- O idioma e o domínio são comparáveis?
- O modelo foi testado com as mesmas ferramentas que usarei?
- A métrica representa uma única tentativa?
- A diferença de score é relevante?
- Existem avisos sobre contaminação?
- Qual é o tipo de erro mais comum?
- Quanto custa uma tarefa concluída?
- Qual é a latência?
- O desempenho permanece em PT-BR?
- O sistema recusa quando deveria?
- Ele também evita recusas desnecessárias?
- Tenho um conjunto de teste próprio?
- Consigo repetir a avaliação depois de uma atualização?
- Existe revisão humana proporcional ao risco?
Perguntas frequentes
Benchmark e eval são a mesma coisa?
Não exatamente. Uma eval é um teste estruturado. Um benchmark normalmente reúne tarefas, dados e métricas padronizados para comparar sistemas.
Quem cria os benchmarks?
Universidades, organizações independentes, empresas de IA, comunidades técnicas e laboratórios podem criar benchmarks. Avalie a metodologia e os conflitos de interesse de cada fonte.
A OpenAI avalia os próprios modelos?
Sim. Ela publica resultados internos e externos, system cards e páginas de lançamento. Alguns testes também são realizados ou corrigidos por organizações e especialistas externos.
Uma avaliação externa é sempre melhor?
Não automaticamente. Ela oferece maior independência, mas ainda precisa de dataset adequado, configuração justa, metodologia transparente e modelo atualizado.
Uma pontuação maior significa um modelo melhor?
Significa melhor resultado naquela avaliação e configuração. Não prova superioridade em todos os usos, idiomas, custos ou riscos.
Por que benchmarks diferentes discordam?
Eles medem tarefas, dados, versões, ferramentas e métricas diferentes. Um modelo pode ser forte em código e menos adequado para factualidade ou escrita profissional.
O que é LLM as a judge?
É o uso de um modelo de linguagem para avaliar outra resposta segundo critérios. O método escala bem, mas precisa ser calibrado com julgamentos humanos.
O que é red teaming?
É a busca adversarial por falhas, riscos e formas de contornar proteções. Pode usar especialistas internos ou externos e complementa os testes estruturados.
System Card é uma certificação de segurança?
Não. É um relatório sobre testes, riscos e mitigações. Ele melhora a transparência, mas não garante ausência de falhas nem substitui avaliação independente.
Os resultados da API valem para o ChatGPT?
Nem sempre. ChatGPT pode incluir roteamento, ferramentas, instruções e limites diferentes da chamada de API usada no benchmark.
Preciso criar minhas próprias evals?
Sim, quando a decisão depende de um produto ou processo real. Benchmarks públicos ajudam na triagem, mas não representam suas políticas, dados e erros mais importantes.
Quantos exemplos uma eval precisa ter?
Não existe um número universal. Comece com exemplos representativos, inclua falhas críticas e amplie o conjunto à medida que surgem novos casos. Uma amostra pequena pode orientar a exploração, mas não sustenta conclusões amplas.
Regra prática
Use benchmarks públicos para entender capacidades gerais e identificar candidatos. Depois, execute os mesmos modelos em tarefas reais do seu contexto, com uma configuração controlada e uma rubrica ligada ao risco.
Compare qualidade, custo, latência, segurança e estabilidade. Analise as falhas por categoria, não apenas a média.
O melhor modelo não é necessariamente aquele que lidera mais tabelas. É aquele que cumpre sua tarefa com qualidade suficiente, custo aceitável, erros controlados e revisão adequada.
Fontes oficiais verificadas
- Como o ChatGPT e os modelos fundamentais são desenvolvidos
- Boas práticas para avaliações
- Introdução a datasets de avaliação
- Graders da OpenAI
- Como trabalhar com evals
- Depreciações da OpenAI API
- SimpleQA
- OpenAI Evals e benchmarks de pesquisa
- GPT‑4o System Card
- GPT‑5 System Card
- Preparedness Framework atualizado
- OpenAI Model Spec
- Página de lançamento do GPT‑5.5 e metodologia das avaliações