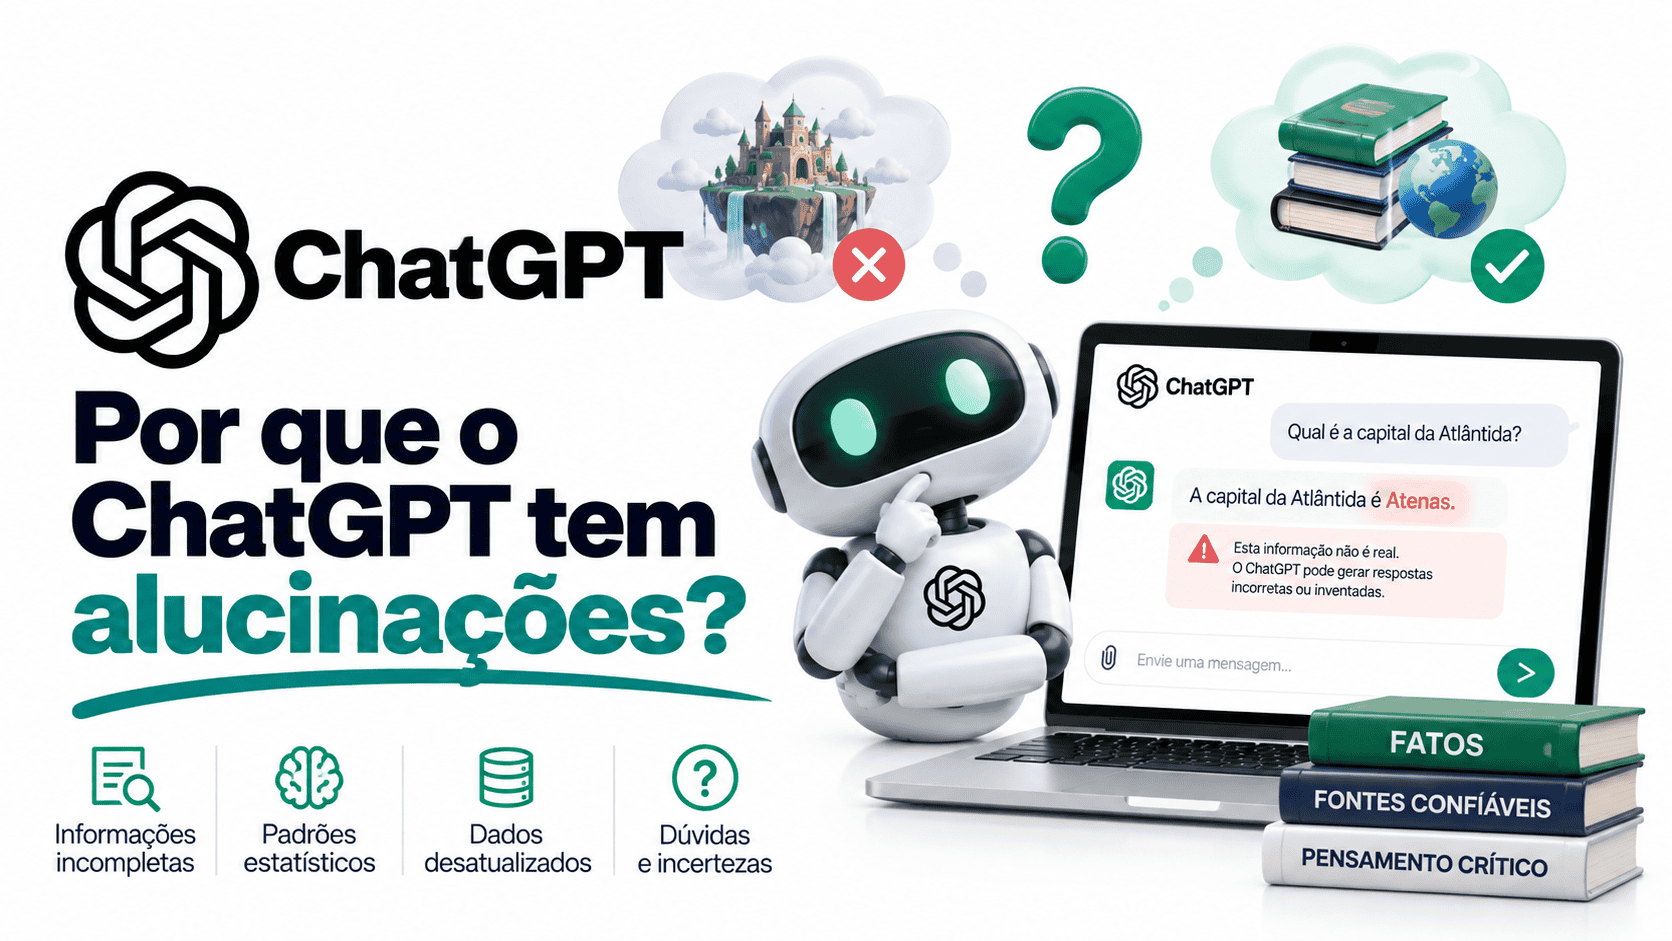

O ChatGPT tem alucinações porque gera respostas a partir de padrões e probabilidades, sem verificar automaticamente cada frase em uma fonte de verdade. Quando faltam dados, o contexto é ambíguo ou a informação é rara, o modelo pode completar a resposta com um detalhe plausível, mas falso.
Uma alucinação pode aparecer como uma data errada, um artigo científico inexistente, uma citação inventada, um parâmetro de API que nunca existiu ou uma conclusão que não está no documento fornecido. A redação pode ser clara, específica e confiante mesmo quando o conteúdo está incorreto.
Fluência não é prova de verdade. Uma resposta bem escrita pode conter uma afirmação falsa, desatualizada ou sem apoio na fonte.
A OpenAI reconhece que o ChatGPT pode produzir fatos incorretos, referências fabricadas e respostas excessivamente confiantes. A orientação oficial é tratar informações importantes de forma crítica e verificá-las em fontes confiáveis. Consulte a página O ChatGPT diz a verdade?.
Informações e recursos verificados em 12 de outubro de 2026. Modelos, ferramentas e interfaces podem mudar.
O que é uma alucinação do ChatGPT?
Alucinação é uma afirmação plausível, mas falsa ou não sustentada, produzida por um modelo de linguagem. O termo não significa que o sistema tenha uma experiência mental semelhante à humana.
Também não significa necessariamente que o ChatGPT esteja “mentindo”. Mentir envolve intenção consciente de enganar. Um modelo de linguagem gera uma continuação com base no texto, no contexto e nos padrões que aprendeu; ele pode produzir informação falsa sem reconhecer que ela é falsa.
| Exemplo | O que pode acontecer |
|---|---|
| Fato | Informar uma data, nome ou número incorreto |
| Fonte | Criar um artigo, autor, DOI ou link inexistente |
| Citação | Atribuir uma frase a alguém que nunca a disse |
| Documento | Acrescentar uma conclusão que não aparece no arquivo |
| Código | Usar uma função, biblioteca ou parâmetro que não existe |
| Cálculo | Aplicar a fórmula errada ou trocar uma unidade |
| Direito | Citar uma regra correta no país, data ou situação errados |
| Pesquisa | Apresentar uma correlação como causa comprovada |
Nem todo erro do ChatGPT é uma alucinação
Separar os tipos de falha ajuda a escolher a correção adequada.
| Tipo de problema | Descrição | Exemplo |
|---|---|---|
| Alucinação factual | O modelo cria uma afirmação falsa ou sem evidência | Inventar o título de um estudo |
| Informação desatualizada | A resposta se baseia em uma situação anterior | Indicar um preço ou modelo que mudou |
| Falta de acesso | O ChatGPT não conseguiu abrir a fonte necessária | Responder sobre uma página protegida por login |
| Erro de interpretação | A fonte existe, mas foi entendida de maneira incorreta | Aplicar uma regra limitada a um grupo para todos os usuários |
| Erro de cálculo | Os dados estão corretos, mas a operação está errada | Somar percentuais de bases diferentes |
| Inferência sem apoio | A conclusão vai além do que os dados permitem | Tratar associação como causalidade |
| Simplificação excessiva | A resposta omite exceções ou controvérsias relevantes | Apresentar uma regra complexa como absoluta |
| Premissa falsa | A pergunta pressupõe algo que não ocorreu ou não existe | Explicar as consequências de uma lei fictícia como se fosse real |
Uma informação antiga pode ser verdadeira no passado, mas incorreta hoje. Uma alucinação pode nunca ter sido verdadeira. Os dois casos precisam de correção, mas têm causas diferentes.
Por que o ChatGPT tem alucinações?
1. O modelo prevê o próximo token
Um modelo de linguagem produz a resposta progressivamente. A cada etapa, estima qual token — uma palavra, parte de palavra ou sinal — é uma continuação provável do contexto anterior.
Essa capacidade gera textos coerentes, mas “linguisticamente provável” não significa “factualmente verdadeiro”. Uma data inventada pode encaixar perfeitamente na frase, mesmo sem existir evidência para ela.
O estudo Why Language Models Hallucinate, publicado por pesquisadores da OpenAI e colaboradores, analisa como erros factuais podem surgir das pressões estatísticas presentes no treinamento de modelos de linguagem.
2. O pré-treinamento não traz uma etiqueta de verdadeiro ou falso para cada frase
Durante o pré-treinamento, o modelo aprende padrões em grandes volumes de texto. Cada afirmação não vem necessariamente acompanhada de uma marca indicando se é verdadeira, falsa, antiga, controversa ou aplicável apenas a determinado contexto.
Os dados podem conter:
- informações corretas e incorretas;
- fontes com datas diferentes;
- opiniões apresentadas como fatos;
- contradições;
- simplificações;
- conteúdo repetido em muitos sites;
- informações que deixaram de ser atuais.
O modelo pode aprender a forma de uma resposta convincente sem possuir um mecanismo infalível para confirmar cada fato usado nessa resposta.
3. Fatos raros são difíceis de deduzir por padrões
Ortografia e estruturas comuns aparecem repetidamente nos dados. Já fatos arbitrários e pouco frequentes — como o título exato de uma dissertação, uma data de nascimento ou o nome de uma função recém-lançada — não podem ser deduzidos com segurança apenas pela regularidade da linguagem.
Quando o modelo reconhece o tipo de informação, mas não possui o dado confiável, pode completar o padrão com um detalhe que parece adequado.
4. Muitas avaliações recompensam o palpite
A pesquisa da OpenAI argumenta que avaliações baseadas somente em respostas certas ou erradas podem criar um incentivo inadequado.
Se dizer “não sei” recebe zero e adivinhar possui alguma chance de acerto, o sistema que tenta responder pode obter uma pontuação maior que um sistema cauteloso. O efeito colateral é uma taxa maior de erros confiantes.
A página oficial Why language models hallucinate defende que erros confiantes devem ser penalizados mais fortemente e que uma abstenção apropriada deve ser valorizada.
Isso não significa que benchmarks sejam a única causa de toda alucinação. Eles ajudam a explicar por que o comportamento de tentar responder pode persistir mesmo quando os modelos melhoram.
5. A pergunta pode estar incompleta ou ser ambígua
“Qual é o prazo legal?” não informa país, tipo de processo, data ou situação. “Qual é o preço do plano?” não identifica produto, moeda, região ou data.
Quando várias interpretações são possíveis, o modelo pode escolher uma delas sem avisar. O comportamento mais seguro seria pedir esclarecimento ou declarar a suposição.
O Model Spec da OpenAI orienta os modelos a expressar incerteza e pedir esclarecimentos quando isso for apropriado, mas a OpenAI também informa que os modelos em produção ainda não refletem perfeitamente todos os comportamentos desejados.
6. A premissa da pergunta pode ser falsa
Considere a pergunta: “Quais mudanças foram aprovadas na Lei Municipal 9.999 de Vale Azul?”. Se a cidade ou a lei não existir, um modelo excessivamente prestativo pode inventar uma descrição em vez de contestar a premissa.
Solicitações como “explique esse estudo” também criam risco quando nenhum estudo foi anexado ou identificado.
7. A informação pode ser recente ou inacessível
Sem pesquisa na web, a resposta depende do conhecimento adquirido durante o treinamento e do contexto fornecido. Eventos posteriores, preços atuais, alterações de política e novas versões podem não estar disponíveis.
Mesmo com pesquisa, uma página pode estar atrás de login ou paywall, bloqueada para rastreamento, removida ou indisponível. O ChatGPT pode não conseguir acessar dados internos de uma empresa, prontuário, processo, painel ou conta privada.
8. O contexto pode ser insuficiente, excessivo ou contraditório
Uma resposta fica mais vulnerável a erros quando:
- o usuário não define termos importantes;
- há várias versões do mesmo documento;
- uma restrição importante aparece muito antes na conversa;
- o arquivo contém textos conflitantes;
- muito material irrelevante oculta a passagem correta;
- não está claro qual fonte prevalece.
Mais contexto não é automaticamente melhor. O contexto precisa ser relevante, identificável e atualizado.
9. A busca ou recuperação pode trazer a passagem errada
Sistemas que pesquisam a web ou uma base documental primeiro recuperam conteúdos e depois geram uma resposta. Esse processo pode falhar em duas etapas:
- recuperação: a passagem certa não foi encontrada, ou foi misturada com conteúdo irrelevante;
- geração: a passagem certa foi fornecida, mas o modelo a interpretou ou sintetizou de maneira incorreta.
A documentação de otimização de precisão da OpenAI explica que um sistema com RAG pode fornecer o contexto errado, excesso de ruído ou o contexto certo usado de modo incorreto pelo modelo.
10. O modelo pode cometer um erro de raciocínio
Mesmo quando os fatos de entrada são corretos, o ChatGPT pode:
- usar a fórmula errada;
- trocar unidades;
- misturar períodos diferentes;
- confundir correlação com causa;
- ignorar uma exceção;
- generalizar um resultado limitado;
- combinar trechos incompatíveis.
Por isso, precisão factual e raciocínio correto precisam ser verificados separadamente.
Por que uma resposta errada pode parecer tão convincente?
O ChatGPT foi treinado para produzir linguagem coerente, relevante e útil. Recursos que melhoram a forma do texto também podem tornar um erro mais persuasivo.
Uma alucinação pode incluir:
- tom profissional;
- títulos e subtítulos;
- números específicos;
- nomes técnicos;
- explicação lógica;
- referências formatadas;
- links com aparência legítima;
- uma conclusão categórica.
Nenhum desses elementos prova que a informação foi verificada. A própria OpenAI alerta que confiança textual não equivale a confiabilidade.
Exemplos de alucinações e como verificá-las
| Resposta aparente | Risco | Verificação |
|---|---|---|
| “O estudo de Silva e Ramos, publicado em 2024, concluiu…” | Estudo, autores ou periódico podem não existir | Buscar título, DOI e registro na base original |
| “A versão 4.7 foi lançada em 18 de março” | Data ou versão pode ter sido completada por padrão | Abrir changelog ou release notes oficiais |
“Use o parâmetro enable_memory=true” | O parâmetro pode não existir | Conferir a documentação da versão atual |
| “A frase foi dita por determinado autor” | Atribuição inventada | Localizar a obra ou gravação primária |
| “A conclusão está na página 47” | A página pode estar errada ou usar outra numeração | Abrir o PDF e localizar o trecho exato |
| “O relatório prova que X causou Y” | O documento pode mostrar apenas associação | Revisar método, limites e linguagem original |
| “O total é R$ 18.420” | Fórmula, imposto ou unidade pode estar errada | Refazer o cálculo com ferramenta determinística |
| “A lei garante esse direito em todos os casos” | País, data, exceção ou jurisdição podem estar errados | Consultar o texto oficial e um profissional quando necessário |
Sinais de que uma resposta precisa de verificação
- O texto apresenta números exatos sem explicar a origem.
- O link não abre ou leva apenas à página inicial de um site.
- O DOI não é encontrado.
- A fonte existe, mas não contém a afirmação citada.
- O nome do documento na resposta não coincide com o link.
- A resposta não informa data, versão, país ou unidade.
- Uma função de código não aparece na documentação oficial.
- A mesma pergunta recebe datas ou nomes diferentes.
- O modelo responde completamente a algo que não pode acessar.
- O resumo inclui uma conclusão mais forte que a fonte.
- A resposta usa “sempre”, “nunca” ou “garantido” em um tema complexo.
- O modelo afirma ter lido um arquivo que não foi anexado.
Esses sinais não provam isoladamente que existe uma alucinação. Eles indicam que o conteúdo não deve ser usado antes da conferência.
Pedir fontes impede o ChatGPT de inventar?
Não. Pedir fontes melhora a rastreabilidade, mas o modelo ainda pode:
- inventar uma referência;
- misturar título, autor e periódico de trabalhos diferentes;
- citar uma fonte real que não sustenta a frase;
- usar uma página desatualizada;
- omitir uma fonte contraditória;
- apontar para uma página genérica em vez do documento direto.
Peça uma relação explícita entre afirmação e evidência:
Responda usando somente fontes que você conseguiu abrir.

Para cada afirmação factual, informe:
- afirmação;
- fonte direta;
- título da página ou documento;
- organização responsável;
- data de publicação ou atualização;
- trecho exato ou seção que sustenta a afirmação;
- limitações da fonte.

Não invente referência.
Não use uma fonte que apenas mencione um tema sem sustentar a afirmação.
Se não encontrar evidência suficiente, escreva [NÃO CONFIRMADO].
Depois, abra cada link e confira o trecho. O prompt melhora o processo, mas não transfere a responsabilidade de verificação para o modelo.
O ChatGPT Search elimina as alucinações?
Não. A busca na web reduz a dependência da memória do modelo e permite consultar informações atuais, mas ainda pode retornar resultados incompletos, antigos ou incorretos.
A documentação de pesquisa na web do ChatGPT recomenda abrir a citação, verificar se ela realmente apoia a resposta, conferir a data e priorizar uma fonte confiável quando a precisão importa.
Use Search para consultas rápidas e atuais
- data de uma atualização;
- preço atual;
- agenda;
- mudança de política;
- lançamento de produto;
- notícia recente;
- documentação vigente.
Inclua data, país, versão e domínio desejado na pergunta para reduzir ambiguidade.
Use Pesquisa aprofundada para questões complexas
A Pesquisa aprofundada pode analisar várias fontes, sites específicos, arquivos e aplicativos compatíveis, produzindo um relatório com citações ou links.
Ela é mais adequada para comparações, relatórios e perguntas com várias etapas. Ainda assim, o usuário precisa revisar as fontes, os recortes, as inferências e as informações ausentes.
Arquivos enviados impedem respostas inventadas?
Não. Anexar a fonte melhora o grounding — o vínculo da resposta com um material fornecido — mas o ChatGPT ainda pode interpretar o arquivo de maneira incorreta.
Os riscos incluem:
- página escaneada ilegível;
- número extraído incorretamente;
- tabela com colunas confundidas;
- gráfico não interpretado;
- trecho relevante não recuperado;
- versões conflitantes;
- resumo que omite uma exceção;
- número de página diferente da numeração impressa.
A página oficial de envio de arquivos ao ChatGPT orienta o usuário a revisar a resposta e observar que o desempenho pode variar conforme o arquivo, o idioma, o modelo e a configuração.
Responda somente com base no arquivo anexado.

Antes de responder:
1. liste as seções que você conseguiu localizar;
2. informe páginas ilegíveis, ausentes ou ambíguas;
3. identifique tabelas, imagens ou anexos que talvez não tenham sido interpretados;
4. diga se a informação solicitada aparece explicitamente.

Na resposta:
- cite a página ou seção;
- diferencie texto explícito de inferência;
- não acrescente conhecimento externo;
- use [NÃO LOCALIZADO] quando a informação não estiver no arquivo;
- não preencha lacunas.
Perguntar “tem certeza?” resolve?
Não de forma confiável. O modelo pode:
- repetir a resposta com mais confiança;
- trocar um erro por outro;
- pedir desculpas sem encontrar evidência;
- alterar detalhes corretos junto com o erro;
- afirmar que verificou algo sem possuir nova fonte.
Peça uma auditoria verificável, não uma confirmação subjetiva:
Audite sua resposta anterior.

Separe cada afirmação verificável em uma linha e classifique como:
- CONFIRMADA;
- PARCIALMENTE CONFIRMADA;
- NÃO CONFIRMADA;
- CONTRADITA.

Para cada linha:
- forneça a fonte direta;
- indique o trecho que sustenta a afirmação;
- informe a data e o escopo;
- explique qualquer inferência;
- remova detalhes sem evidência.

Não considere a repetição da resposta como verificação.
Como verificar uma resposta do ChatGPT passo a passo
- Quebre a resposta em afirmações: datas, números, nomes, regras, citações e conclusões.
- Classifique cada item: fato, cálculo, inferência, opinião ou previsão.
- Escolha a fonte de verdade: documento oficial, base científica, contrato, sistema interno ou especialista.
- Abra o documento: não valide uma citação apenas pela aparência.
- Localize o trecho: confirme que a fonte sustenta exatamente a frase.
- Confira escopo e data: país, versão, população, unidade e período.
- Refaça os cálculos: use uma planilha, calculadora ou código reproduzível.
- Procure contradições: consulte uma segunda fonte primária quando o risco justificar.
- Atribua um status: confirmado, parcial, não confirmado ou contradito.
- Remova o que não foi sustentado: não publique uma afirmação apenas porque parece provável.
Prompts para reduzir o risco de alucinação
Nenhum prompt elimina o problema, mas instruções claras podem reduzir o incentivo para preencher lacunas.
Resposta com fontes oficiais
Responda à pergunta abaixo usando fontes oficiais e atuais.

Pergunta:
[pergunta]

Contexto:
[país, data, versão e situação]

Regras:
- não responda somente pela memória;
- não invente número, data, nome ou link;
- use fontes primárias;
- coloque o link direto ao lado da afirmação;
- informe a data da fonte;
- diferencie fato de inferência;
- escreva [NÃO CONFIRMADO] se não houver evidência suficiente;
- faça perguntas antes de responder se o contexto estiver ambíguo.
Separar fatos, inferências e dúvidas
Analise o tema abaixo e divida a resposta em quatro seções:

1. Fatos confirmados por fonte.
2. Inferências razoáveis.
3. Informações incertas ou conflitantes.
4. Dados que ainda precisam ser obtidos.

Para cada fato, inclua uma fonte direta.
Não transforme uma inferência em fato.
Não preencha um campo apenas para completar a resposta.
Verificar referências acadêmicas
Localize estudos reais sobre:

[tema]

Para cada estudo, informe:
- título exato;
- autores;
- periódico ou repositório;
- ano;
- DOI ou URL oficial;
- desenho do estudo;
- população;
- principal resultado;
- limitações.

Não crie referências.
Não complete metadados ausentes por estimativa.
Se você não conseguir abrir ou confirmar uma referência, não a inclua.
Depois, apresente uma tabela de verificação com o status de cada link.
Conferir cálculo
Verifique este cálculo de forma reproduzível.

Dados:
[dados]

Fórmula esperada:
[fórmula ou regra]

Entregue:
1. variáveis e unidades;
2. fórmula usada;
3. substituição dos valores;
4. resultado intermediário;
5. resultado final;
6. teste de consistência;
7. premissas;
8. dados ausentes.

Não altere unidades silenciosamente.
Não estime um valor ausente.
Se houver mais de uma interpretação, calcule cada cenário separadamente.
Conferir código e API
Revise o código abaixo com base na documentação oficial atual.

Tecnologia:
[produto, linguagem, SDK e versão]

Código:
[código]

Verifique:
- se o pacote existe;
- se o método existe;
- se os parâmetros são válidos;
- se o endpoint está ativo;
- se há depreciação;
- se a autenticação está correta;
- se o exemplo possui risco de segurança.

Inclua links diretos à documentação.
Não invente método ou parâmetro.
Não diga que o código foi testado se você não o executou.
Auditar um resumo de documento
Audite este resumo contra o documento original.

Para cada frase do resumo:
- localize o trecho de origem;
- cite a página ou seção;
- classifique como fiel, exagerada, incompleta ou não localizada;
- identifique informações importantes omitidas;
- separe conclusão do documento de interpretação do redator.

Remova qualquer frase sem apoio verificável.
Exemplo prático: verificar uma função de API
Imagine que um desenvolvedor pergunta: “Como usar a função automática de memória no SDK atual?”.
Fluxo de alto risco
- Não identifica a empresa ou o SDK.
- Não informa a linguagem ou a versão.
- Pede um exemplo completo.
- Copia o primeiro código gerado.
- Presume que os parâmetros são reais.
O ChatGPT pode produzir um método plausível porque nomes como enable_memory, memory_config ou persistent_context combinam com padrões comuns de APIs. Isso não prova que algum deles exista.
Fluxo mais seguro
- Identificar provedor, produto, linguagem, pacote e versão.
- Restringir a pesquisa à documentação oficial.
- Pedir o link da página exata do método.
- Conferir assinatura, tipos e parâmetros.
- Revisar changelog e depreciações.
- Executar o exemplo em ambiente isolado.
- Adicionar tratamento de erro.
- Nunca inserir uma chave real no chat ou no código publicado.
O ChatGPT pode acelerar a leitura e preparar um rascunho. A existência da função e o comportamento real precisam ser confirmados na documentação e na execução.
Como reduzir alucinações em um aplicativo com a OpenAI API
Para desenvolvedores, a redução de erros exige um processo de avaliação, não apenas um prompt mais longo.
- Defina precisão: estabeleça o que conta como resposta correta, incompleta, errada ou aceitavelmente incerta.
- Crie um conjunto de testes: inclua casos comuns, ambíguos, adversariais e sem resposta disponível.
- Meça abstenção: avalie se o sistema diz que não sabe quando deveria.
- Avalie a recuperação: confirme se o sistema trouxe o documento ou trecho correto.
- Avalie a geração: verifique se a resposta respeita o contexto recuperado.
- Reduza ruído: não envie grandes blocos irrelevantes apenas porque cabem no contexto.
- Exija evidência: associe cada afirmação a uma fonte ou trecho.
- Use cálculo determinístico: números críticos devem ser processados por código ou ferramenta adequada.
- Adicione revisão humana: principalmente antes de ações externas ou decisões de alto impacto.
- Registre falhas: transforme erros reais em novos casos de teste.
- Repita os testes: execute os evals ao mudar prompt, modelo, ferramenta ou base.
RAG não elimina a alucinação
RAG, ou geração aumentada por recuperação, adiciona trechos de uma base ao contexto. Ele pode aumentar a precisão, mas ainda falha quando:
- a consulta recupera o documento errado;
- o fragmento é insuficiente;
- o texto relevante está em uma imagem;
- há versões conflitantes;
- muito ruído oculta a evidência;
- o modelo interpreta o trecho de forma incorreta.
Saída estruturada garante formato, não verdade
Um esquema pode exigir campos como resposta, fonte e status. Isso melhora a consistência do formato, mas um campo bem formado ainda pode conter um fato incorreto.
{
  "resposta": "...",
  "status": "confirmado | incerto | não localizado",
  "evidencia": "...",
  "fonte": "...",
  "informacao_ausente": "..."
}
O aplicativo precisa validar a URL, a evidência e a relação entre fonte e afirmação.
Fine-tuning não substitui uma fonte atual
Fine-tuning pode melhorar estilo, formato e consistência em uma tarefa. Ele não deve ser tratado como a forma principal de manter fatos atuais. Para informações mutáveis, use fontes atualizadas e recuperação verificável.
Quando a revisão humana é obrigatória?
Quanto maior o impacto do erro, menos adequado é usar a resposta sem verificação.
| Área | Risco | Fonte de confirmação |
|---|---|---|
| Saúde | Diagnóstico, medicamento ou atraso no atendimento | Profissional qualificado e fonte oficial |
| Direito | Prazo, jurisprudência ou regra incorreta | Texto oficial, tribunal e advogado |
| Finanças | Perda, imposto ou projeção enganosa | Instituição, documento oficial e profissional |
| Segurança | Exposição de sistema ou dano físico | Procedimento aprovado e especialista |
| Notícias | Desinformação e dano reputacional | Fonte primária e confirmação independente |
| Engenharia | Falha estrutural ou operacional | Norma, cálculo e responsável técnico |
| Dados pessoais | Violação de privacidade | Política, responsável de dados e controles internos |
O ChatGPT pode ajudar a localizar, resumir e organizar informações. Ele não assume a responsabilidade profissional pela decisão.
Erros comuns ao tentar evitar alucinações
- Pedir “não invente” e considerar o problema resolvido.
- Confiar em uma referência apenas porque está formatada corretamente.
- Aceitar a resposta após perguntar “tem certeza?”.
- Considerar duas respostas iguais como confirmação independente.
- Usar um segundo modelo sem conferir a fonte primária.
- Copiar um número sem revisar a unidade e a fórmula.
- Presumir que a busca abriu e leu toda a página.
- Presumir que um PDF enviado foi interpretado por completo.
- Enviar mais contexto irrelevante para “aumentar a precisão”.
- Usar fine-tuning para resolver falta de dados atuais.
- Tratar um formato JSON válido como evidência de verdade.
- Publicar a primeira versão sem uma etapa de verificação.
Checklist antes de usar uma resposta
- A pergunta informa país, data, versão e contexto?
- O ChatGPT tinha acesso à informação necessária?
- A resposta distingue fato de inferência?
- Os links abrem?
- A fonte contém a afirmação?
- A data da fonte é adequada?
- A regra se aplica à jurisdição e ao público corretos?
- O cálculo foi reproduzido?
- O documento foi comparado com o original?
- As limitações foram registradas?
- Uma informação ausente foi marcada como ausente?
- Existe revisão profissional para uma decisão de alto impacto?
- A afirmação sem evidência foi removida?
Perguntas frequentes
O ChatGPT mente?
“Mentir” não é o termo técnico mais preciso, porque implica intenção consciente. O ChatGPT pode gerar uma afirmação falsa de maneira confiante sem saber que ela é falsa.
Modelos mais novos ainda têm alucinações?
Sim. Modelos mais recentes podem reduzir determinadas taxas de erro, mas nenhum modelo de linguagem deve ser tratado como infalível.
Modelos de raciocínio não deveriam verificar melhor?
O raciocínio pode melhorar tarefas complexas, mas não cria um fato ausente nem garante que a fonte recuperada esteja correta. O modelo também pode raciocinar a partir de uma premissa errada.
A busca na web impede respostas falsas?
Não. Ela fornece acesso a informações atuais e citações, mas resultados, fontes e interpretações ainda precisam ser revisados.
Deep Research pode alucinar?
Pode cometer erro de seleção, síntese ou inferência. A vantagem é oferecer um plano, várias fontes e citações que facilitam a auditoria.
Por que o ChatGPT inventa artigos acadêmicos?
Ele reconhece o padrão de uma referência — autores, título, periódico, ano e DOI — e pode completar campos plausíveis quando não possui uma referência confirmada.
Pedir para não inventar resolve?
Ajuda a orientar o comportamento, mas não garante o resultado. Combine a instrução com fontes delimitadas, marcação de incerteza e verificação externa.
Temperatura baixa elimina alucinações?
Não. Em aplicações de API, reduzir variação pode tornar a saída mais consistente, mas uma resposta consistente ainda pode estar factualmente errada.
RAG elimina alucinações?
Não. RAG oferece contexto externo, mas a recuperação pode falhar e o modelo pode interpretar o trecho incorretamente.
Fine-tuning elimina alucinações?
Não. Ele pode melhorar um comportamento específico, mas não substitui fontes atuais, testes, recuperação adequada e revisão.
Posso confiar em código gerado pelo ChatGPT?
Use-o como rascunho. Confira a documentação, revise segurança e dependências, execute testes e nunca presuma que um pacote ou método existe apenas porque o código parece correto.
A alucinação poderá ser eliminada?
As taxas podem continuar diminuindo, mas perguntas sem resposta disponível, dados ambíguos e fontes incompletas tornam irrealista esperar precisão total em todas as situações. Um sistema confiável também precisa saber se abster.
Regra prática
Use o ChatGPT para explorar, organizar, resumir e criar uma primeira versão. Para uma afirmação importante, identifique a fonte de verdade, abra o documento, localize o trecho e confira data, escopo e contexto.
Quando não houver evidência suficiente, a resposta correta não é preencher o espaço com algo plausível. É registrar que a informação não foi confirmada.
A melhor proteção contra alucinações não é um prompt mágico. É um processo que combina contexto claro, fontes adequadas, ferramentas corretas, incerteza explícita, verificação e revisão humana proporcional ao risco.
Fontes oficiais e primárias verificadas
- OpenAI: Why language models hallucinate
- Artigo científico: Why Language Models Hallucinate
- OpenAI: O ChatGPT diz a verdade?
- OpenAI Model Spec
- OpenAI: Introducing SimpleQA
- OpenAI: pesquisa na web com o ChatGPT
- OpenAI: Pesquisa aprofundada no ChatGPT
- OpenAI: envio de arquivos e áudio ao ChatGPT
- OpenAI: otimização da precisão de modelos
- OpenAI: engenharia de prompts
- OpenAI: avaliação de saídas de modelos