
Teste realizado em 30 de julho de 2026. Esta análise usa arquivos sintéticos, sem dados pessoais, e informa separadamente o que foi observado no teste e o que consta na documentação oficial da OpenAI.
O ChatGPT conseguiu localizar informações verificáveis em três PDFs de texto com 30, 120 e 300 páginas no nosso teste controlado. Em nove respostas, recuperou corretamente códigos colocados no começo, no meio e no fim de cada arquivo, indicou as páginas correspondentes e contou todas as ocorrências de uma expressão de controle. O resultado foi 9/9 respostas corretas para as tarefas avaliadas.
Isso não significa que o ChatGPT “leia perfeitamente” qualquer documento de 300 páginas. Os arquivos eram PDFs digitais, estruturados e sem OCR, imagens, tabelas ou diagramação complexa. Além disso, cada arquivo foi enviado uma única vez e o mesmo prompt foi repetido três vezes na mesma conversa; as respostas 2 e 3 podem ter se beneficiado do contexto criado pela primeira resposta.
Resposta curta: documentos longos podem funcionar muito bem para buscas específicas e verificáveis, mas páginas, megabytes e limite de upload não são medidas de compreensão. Formato, quantidade de texto, qualidade da extração, pergunta e mecanismo de recuperação continuam determinantes.
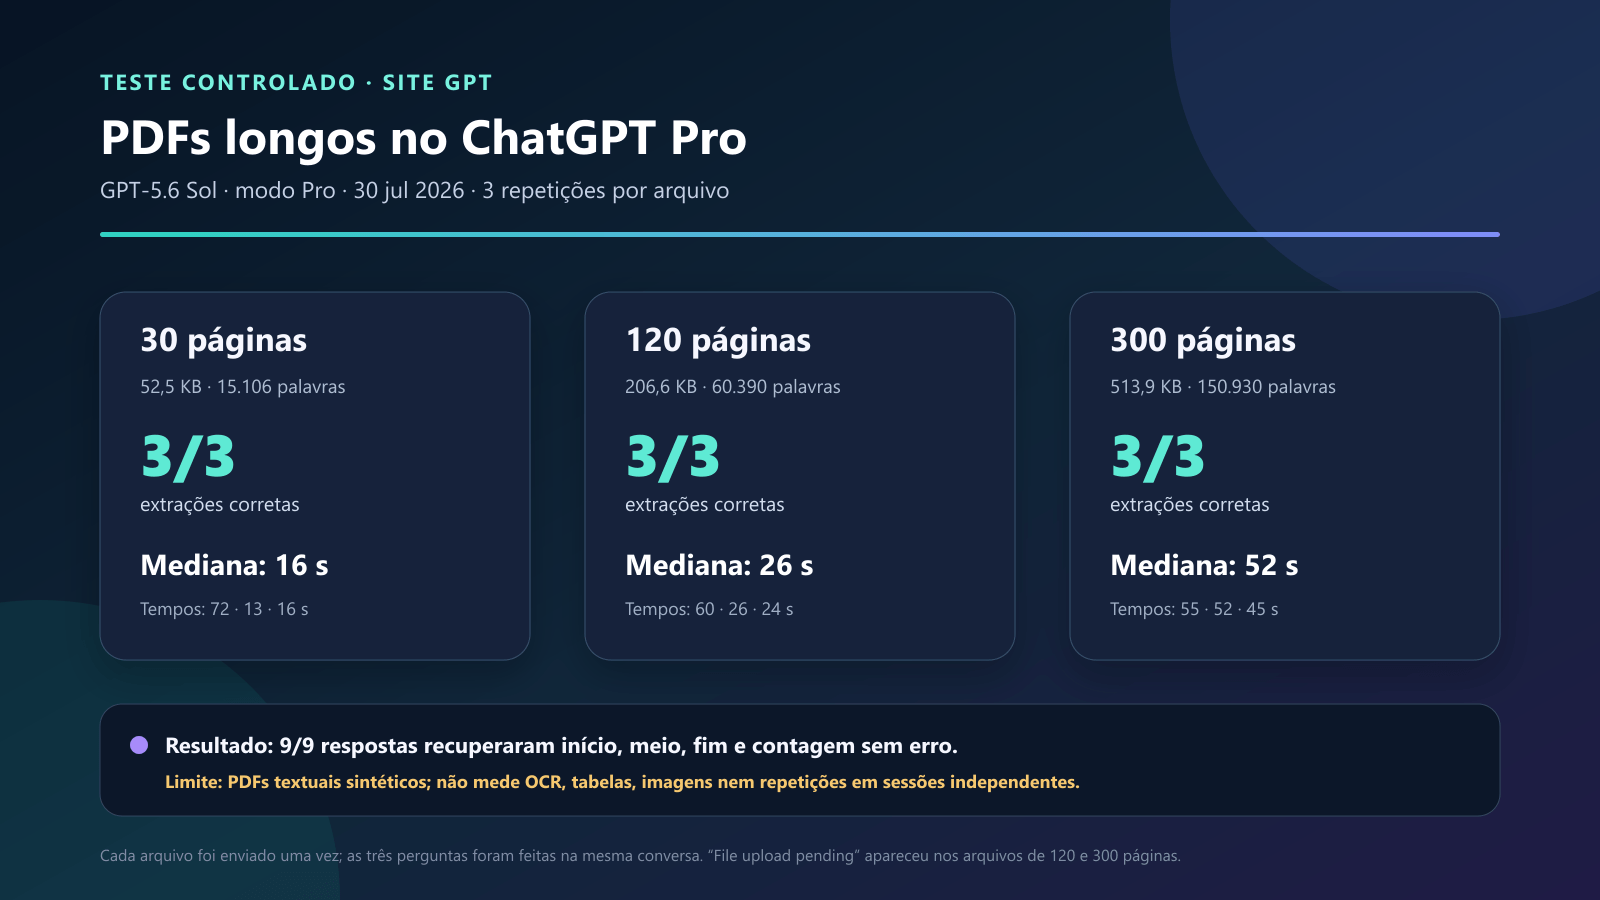
Resultado do teste em uma tabela
| Arquivo | Tamanho | Palavras | Acertos | Tempos observados na interface | Mediana |
|---|---|---|---|---|---|
| PDF de 30 páginas | 52.543 bytes | 15.106 | 3/3 | 72 s, 13 s, 16 s | 16 s |
| PDF de 120 páginas | 206.620 bytes | 60.390 | 3/3 | 60 s, 26 s, 24 s | 26 s |
| PDF de 300 páginas | 513.944 bytes | 150.930 | 3/3 | 55 s, 52 s, 45 s | 52 s |
Os três arquivos somavam 450 páginas e 226.426 palavras. Não houve erro de conteúdo nas verificações propostas. A mensagem File upload pending apareceu antes do envio nos testes de 120 e 300 páginas; aguardamos o processamento do anexo antes de enviar o prompt, e o upload foi concluído.
O que foi testado
O ensaio foi feito na interface web do ChatGPT, em uma conta ChatGPT Pro. A interface exibia o modo Intelligence e a identificação GPT-5.6 Sol. Esse registro descreve a condição visível no momento do teste; modelos e rótulos de interface podem mudar. Os preços e planos do ChatGPT também podem variar com data, conta e região.
- Formato: PDF com texto digital selecionável.
- Tamanhos: 30, 120 e 300 páginas.
- Conteúdo: texto sintético original, sem informações pessoais ou confidenciais.
- Controles: códigos únicos distribuídos no início, no meio e no final, números de página explícitos e ocorrências conhecidas da expressão
LUMEN-CEDRO. - Tarefas: recuperar os três códigos, informar suas páginas e contar a expressão de controle.
- Repetições: três respostas para o mesmo prompt em cada arquivo.
- Critério de acerto: todos os valores e páginas precisavam coincidir com o gabarito do arquivo; a contagem também precisava ser exata.
Os arquivos podem ser identificados pelos seguintes hashes SHA-256 completos: 5e88eddbc03d28556795c4625de8bcac3e2bf61e170dd9b6206cbcd123cbb04e (30 páginas), 71e40689df553e4a3ccca8ce0b5442f8c2823f362386abe437060427e8721f05 (120 páginas) e f66bb5b346c1456c4b288e0611d7d31e4c95ff738e3a47e23aba2d3679c808a8 (300 páginas). Eles identificam exatamente os três arquivos sintéticos usados neste teste e permitem verificar se uma cópia permanece idêntica byte a byte.
Metodologia e como interpretar os tempos
1. Um arquivo por conversa de teste
Cada PDF foi anexado uma vez. Depois que a interface indicou que o arquivo estava pronto, enviamos o mesmo conjunto de verificações. Isso isolou os três tamanhos, mas não criou três sessões independentes para cada tamanho.
2. Três respostas no mesmo contexto
O prompt foi repetido três vezes dentro da conversa que já continha o arquivo. Esse desenho mede consistência dentro de uma sessão, não independência estatística. Depois da primeira resposta, o histórico pode manter valores já encontrados e favorecer as execuções seguintes. Por isso, não apresentamos “taxa de precisão geral” do ChatGPT nem intervalo de confiança.
3. Cronometragem pela interface
O tempo foi observado do envio do prompt até a conclusão visível da resposta. Ele inclui fatores que não controlamos, como fila do serviço, processamento do arquivo, rede, carga do sistema e variação de geração. Não é correto tratá-lo como latência pura do modelo ou compará-lo diretamente com medições de API.
4. Gabarito determinístico
As perguntas tinham resposta conhecida antes do envio. Isso evita avaliar uma resposta apenas porque “parece boa”. Um código incorreto, uma página errada ou uma contagem diferente do gabarito tornaria a execução incorreta.
Resultados por tamanho
PDF de 30 páginas
O arquivo tinha 15.106 palavras e 52.543 bytes. As três respostas passaram por todas as verificações. Os tempos foram 72, 13 e 16 segundos, com mediana de 16 segundos. A diferença entre a primeira e as demais execuções mostra por que uma observação isolada não deve virar promessa de velocidade.
PDF de 120 páginas
O arquivo tinha 60.390 palavras e 206.620 bytes. As três respostas também foram corretas, em 60, 26 e 24 segundos, com mediana de 26 segundos. Antes do envio apareceu File upload pending. Aguardamos o término do processamento; não houve falha depois disso.
PDF de 300 páginas
O maior arquivo tinha 150.930 palavras e 513.944 bytes. Ele produziu três respostas corretas em 55, 52 e 45 segundos, com mediana de 52 segundos. Também houve a indicação temporária File upload pending antes do prompt.
O PDF de 300 páginas era longo em texto, mas pequeno em tamanho binário: aproximadamente meio megabyte. Portanto, este teste não avalia a proximidade do limite de 512 MB por arquivo. “300 páginas” não equivale a “arquivo pesado”, especialmente quando o documento contém apenas texto.
O que o teste demonstra — e o que não demonstra
O teste fornece evidência direta de que, nessa conta, nesse dia e com esses arquivos, o ChatGPT recuperou corretamente informações distribuídas por PDFs de até 300 páginas. A presença de um código perto do final do documento não impediu sua localização, e a contagem da expressão de controle também coincidiu com o gabarito.
Ele não demonstra que todo o conteúdo ficou simultaneamente na janela de contexto. Um sistema pode localizar trechos por busca interna sem colocar o documento inteiro no contexto ativo. O acerto em alvos conhecidos também não prova compreensão integral, qualidade de resumo, raciocínio jurídico, leitura de gráficos ou interpretação de tabelas.
- Não testamos PDF escaneado ou OCR.
- Não testamos tabelas, gráficos, imagens, notas de rodapé ou múltiplas colunas.
- Não testamos documentos jurídicos, médicos ou financeiros reais.
- Não testamos vários arquivos ao mesmo tempo.
- Não comparamos planos, modelos ou concorrentes.
- Não repetimos cada execução em uma conversa limpa.
- Usamos apenas um arquivo por tamanho.
Esses limites impedem generalizações como “o ChatGPT entende qualquer PDF de 300 páginas” ou “300 páginas levam cerca de 52 segundos”. A conclusão defensável é mais estreita: as tarefas de recuperação definidas funcionaram nos três arquivos controlados.
Limites oficiais de upload no ChatGPT
Na revisão desta página, a FAQ oficial de upload de arquivos da OpenAI informava:
- limite rígido de 512 MB por arquivo enviado a uma conversa ou GPT;
- limite de 2 milhões de tokens por arquivo de texto ou documento, sem aplicação desse teto a planilhas;
- aproximadamente 50 MB para CSV e planilhas, conforme o tamanho das linhas;
- 20 MB por imagem;
- até 80 uploads por usuário a cada três horas, com possibilidade de redução em horários de pico;
- três uploads por dia para usuários Free;
- armazenamento compartilhado de 25 GB por usuário e 100 GB por organização;
- até 40 arquivos por Project em Pro, Business, Team e Education, e até 20 em Plus.
Esses limites respondem “o arquivo pode ser aceito?”, não “cada detalhe será recuperado corretamente?”. Um PDF de 500 MB pode conter principalmente imagens; outro de menos de 1 MB pode conter centenas de páginas de texto denso. Tokens, extração, estrutura e objetivo da pergunta são medidas diferentes.
A OpenAI também informa que tentativas de upload malsucedidas podem contar para o limite móvel e que a interface não mostra quanto resta dessa cota. Se aparecer upload limit reached, confirme a conta e o plano, verifique o armazenamento em Settings > Storage e consulte o status oficial do serviço.
Janela de contexto, extração e recuperação
A janela de contexto não deve ser confundida com o limite de upload. Ela é o espaço de trabalho do modelo para instruções, histórico, conteúdo incluído, trechos recuperados e resposta. Quando um documento excede o conteúdo que pode ser inserido diretamente, uma implementação pode indexar partes do arquivo e recuperar trechos relacionados à pergunta.
A OpenAI publica uma explicação detalhada de context stuffing e busca privada para ChatGPT Enterprise. Essa documentação menciona até 110 mil tokens de documentos inseridos diretamente em determinados fluxos Enterprise, com o restante enviado a um índice de busca. Esse número é específico daquela documentação e pode mudar; ele não deve ser apresentado como limite garantido do ChatGPT Pro.
Nosso teste em Pro observou o resultado final, não o caminho interno usado para produzi-lo. Não temos como afirmar, apenas olhando a resposta, se um trecho estava no contexto direto ou foi recuperado de um índice. Os acertos no começo, meio e fim são compatíveis com recuperação eficaz, mas não revelam a arquitetura usada naquela sessão.
PDFs com imagens e documentos escaneados
Este ensaio não avaliou elementos visuais. Segundo a FAQ oficial, o ChatGPT Enterprise oferece Visual Retrieval para PDFs em fluxos compatíveis. Nos demais planos e em outros tipos de documento, a recuperação indicada pela OpenAI é baseada em texto e imagens incorporadas podem ser descartadas.
Por isso, não extrapole estes resultados para contratos escaneados, laudos fotografados, diagramas, plantas, gráficos ou tabelas cujo significado depende do layout. Um PDF pode ter 300 páginas “visíveis” e quase nenhum texto extraível. Antes de enviar, tente selecionar e copiar uma frase. Se o texto não puder ser selecionado, trate OCR como uma variável separada e valide cada número crítico no original.
Como pedir respostas auditáveis em documentos longos
Uma pergunta específica permite verificar a resposta. Em vez de pedir “resuma tudo”, defina uma tarefa, uma evidência obrigatória e uma regra para informação ausente.
Use apenas o documento anexado.

Responda à pergunta: [pergunta específica].

Para cada afirmação, informe:
1. resposta objetiva;
2. número da página e título da seção;
3. trecho curto usado como evidência;
4. pontos incertos ou contraditórios.

Se a informação não estiver no arquivo, escreva:
"Não encontrado no documento".
Não complete lacunas com conhecimento externo.
Para tarefas críticas, faça perguntas separadas. Primeiro localize a cláusula ou o dado; depois confirme a exceção; por fim, peça uma síntese. A própria documentação Enterprise da OpenAI recomenda menos arquivos, perguntas focadas e mecanismos que conectem cada resposta ao trecho exato da fonte.
Protocolo melhor para um próximo teste
Para aumentar a força da evidência, uma próxima rodada deve manter os mesmos arquivos e abrir uma conversa nova para cada repetição. A ordem das perguntas pode ser alternada, e um avaliador deve comparar as respostas com o gabarito sem saber qual tamanho foi testado.
- Use pelo menos três arquivos independentes por faixa de tamanho.
- Execute cada tentativa em uma conversa limpa.
- Registre plano, modelo exibido, data, navegador e idioma.
- Separe tempo de upload, tempo até o primeiro conteúdo e tempo total.
- Inclua uma pergunta cuja resposta não existe para medir alucinação.
- Inclua contradições controladas e fatos distribuídos em seções distantes.
- Teste separadamente PDF digital, PDF com OCR, tabelas e conteúdo visual.
- Publique prompt, gabarito, hashes integrais e regra de pontuação.
Privacidade e documentos reais
Não usamos arquivos reais neste teste. Antes de enviar contratos, relatórios internos ou dados de clientes, verifique autorização, política da organização e necessidade de anonimização. A FAQ de uploads informa que arquivos associados a chats são mantidos de acordo com a retenção da conversa e que, após excluir o chat ou a conta, a exclusão dos arquivos associados normalmente ocorre em até 30 dias, salvo exceções legais, de segurança ou conteúdo previamente desvinculado da conta.
Para decisões jurídicas, médicas, financeiras, trabalhistas ou regulatórias, use a resposta como apoio à localização de evidências, nunca como substituto de revisão profissional. A página, o trecho e o documento original continuam sendo a fonte a conferir.
Perguntas frequentes
O ChatGPT consegue ler um PDF de 300 páginas?
No nosso teste, ele recuperou corretamente os fatos controlados em um PDF digital de 300 páginas e 150.930 palavras. Isso não garante o mesmo resultado para PDFs escaneados, arquivos com tabelas ou qualquer outro documento de 300 páginas.
Qual é o limite de um PDF no ChatGPT?
A FAQ oficial informava 512 MB por arquivo e até 2 milhões de tokens para arquivos de texto e documentos na data desta revisão. O limite de aceitação não representa garantia de compreensão ou precisão.
O número de páginas define o tamanho para o ChatGPT?
Não. Páginas dependem de fonte, margens, imagens e diagramação. O PDF de 300 páginas usado aqui tinha apenas 513.944 bytes, embora reunisse 150.930 palavras. Tamanho em bytes, tokens, páginas e complexidade visual medem coisas diferentes.
Por que apareceu File upload pending?
A indicação significa que o anexo ainda estava sendo processado. Ela apareceu nos arquivos de 120 e 300 páginas. Aguardamos o término antes de enviar a pergunta. Se persistir, não force várias tentativas: uploads com falha podem consumir a cota móvel.
O teste prova que o documento inteiro entrou na janela de contexto?
Não. O comportamento observado pode envolver texto incluído diretamente, recuperação por busca ou uma combinação. A interface não mostra qual caminho interno foi usado em cada resposta.
É melhor dividir um documento longo?
Depende da tarefa. Para perguntas sobre uma seção específica, dividir por capítulos pode reduzir ruído. Para relações entre partes distantes, mantenha o original, peça evidências por etapa e depois valide a síntese. Preserve paginação e referências ao criar versões divididas.
Conclusão
Nos três PDFs sintéticos, o ChatGPT Pro com GPT-5.6 Sol acertou todas as verificações definidas, inclusive no arquivo de 300 páginas. O achado é útil porque foi medido contra respostas conhecidas, e não por impressão subjetiva.
A limitação é igualmente importante: nove respostas, três arquivos de texto e repetições no mesmo contexto não permitem prometer desempenho geral. A forma mais segura de trabalhar com documentos longos é fazer perguntas específicas, exigir página e evidência, registrar incertezas e conferir cada ponto crítico no arquivo original.
Fontes e transparência
- OpenAI — File Uploads FAQ: formatos, limites, cotas, armazenamento, retenção e tratamento de imagens.
- OpenAI — Optimizing File Uploads in ChatGPT Enterprise: extração de texto, context stuffing, índice privado e estratégias de busca. Os números dessa página são específicos de Enterprise.
- OpenAI Status: incidentes que podem afetar uploads e respostas.
Site GPT é um projeto editorial independente e não representa a OpenAI. ChatGPT e GPT são marcas associadas à OpenAI. Nenhuma empresa citada revisou ou patrocinou este teste.