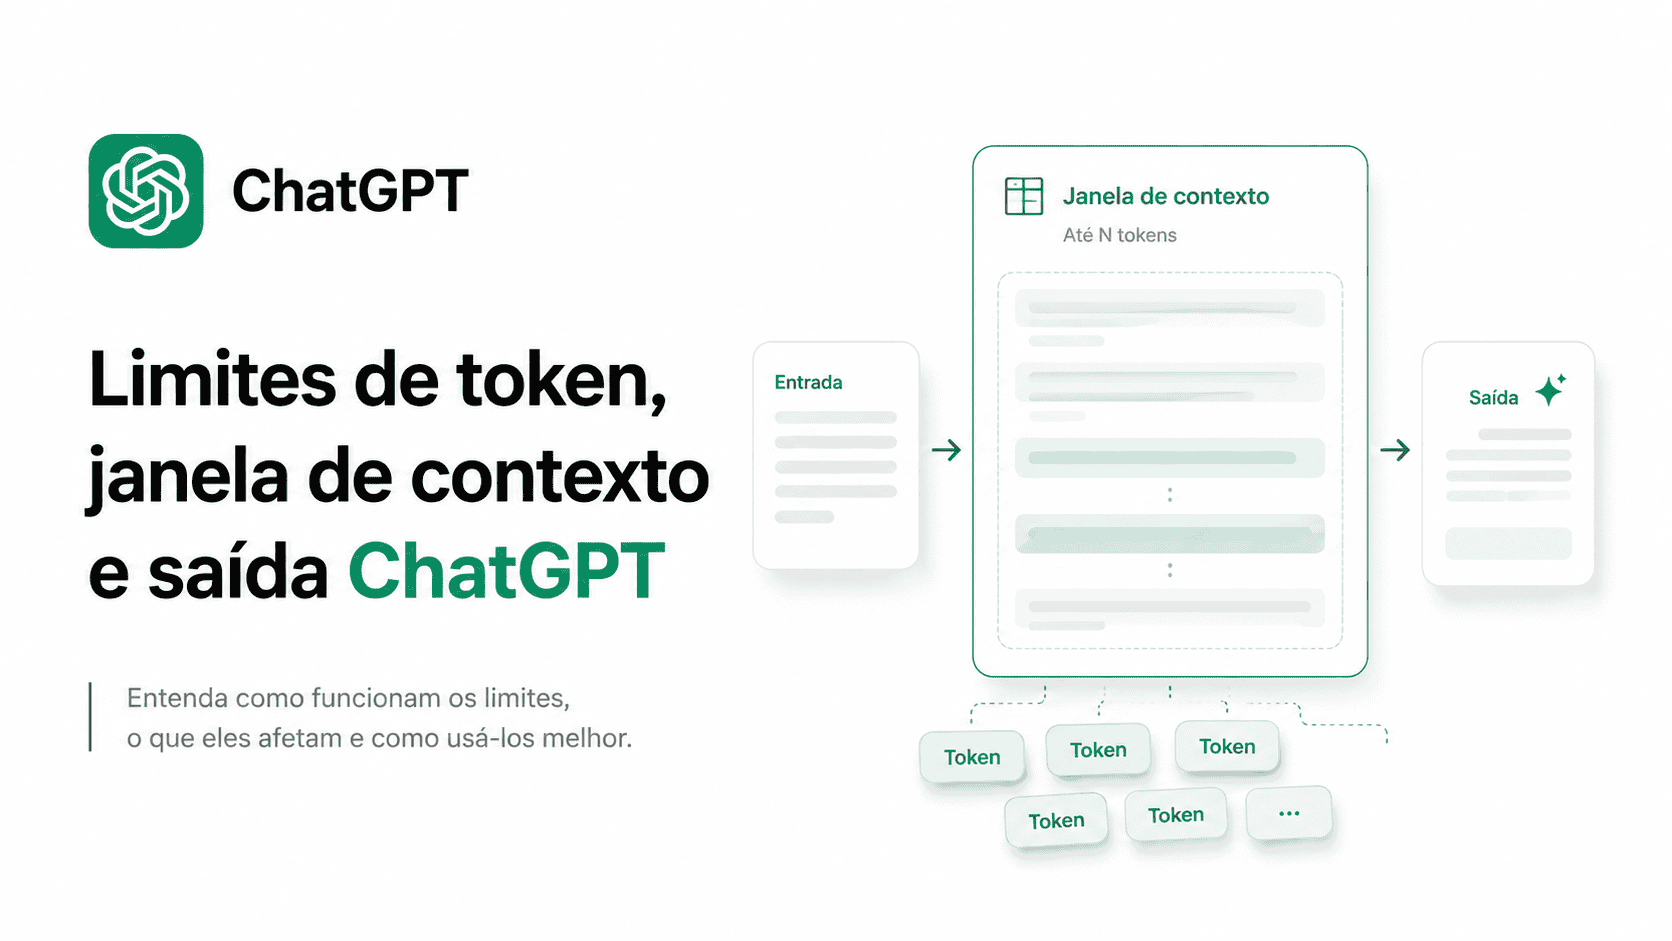

Limite de tokens, janela de contexto e limite de saída são conceitos relacionados, mas não equivalentes. A janela de contexto é o orçamento total de uma solicitação; a entrada ocupa parte desse espaço; e o limite de saída controla quanto o modelo pode gerar. Em modelos de raciocínio, tokens internos também podem consumir o orçamento disponível antes da resposta visível.
Última revisão factual: 22 de julho de 2026.
Transparência: o Site GPT é independente e não representa nem é afiliado à OpenAI. ChatGPT e os modelos GPT são produtos da OpenAI. Os limites mudam conforme modelo, snapshot, endpoint, plano e produto; confirme sempre a página oficial específica antes de projetar uma integração.
Resumo rápido
- Token é uma unidade de texto processada pelo modelo; não corresponde necessariamente a uma palavra.
- Tokens de entrada incluem mais do que a pergunta: instruções, histórico enviado, arquivos processados, imagens, definições de ferramentas e resultados de ferramentas também podem entrar na contagem.
- Janela de contexto é o máximo combinado que pode ser usado em uma solicitação, incluindo entrada, saída e, quando aplicável, tokens de raciocínio.
- Limite de saída é o teto de tokens gerados pelo modelo em uma resposta. Ele pode incluir tokens de raciocínio e de formatação que não aparecem no texto visível.
- Cache pode reduzir custo e latência, mas não aumenta a janela de contexto nem torna a entrada gratuita.
- Histórico, memória, limite de mensagens, tamanho de arquivo e rate limit são limites diferentes.
- Não existe um único número chamado “limite do ChatGPT”. Consulte a documentação do modelo, plano e modo utilizados.
Token limit vs context window vs max output
| Termo | O que significa | Erro comum |
|---|---|---|
| Token | Unidade em que texto e outros conteúdos processados são representados para o modelo | Assumir que um token é sempre uma palavra |
| Tokens de entrada | Conteúdo renderizado para o modelo antes e durante a solicitação | Contar apenas a mensagem do usuário |
| Tokens de saída | Tokens gerados pelo modelo, incluindo componentes que podem não ser texto visível | Confundir saída reportada com palavras exibidas |
| Janela de contexto | Máximo combinado de entrada, saída e raciocínio aplicável em uma solicitação | Tratar como memória permanente |
| Limite máximo de saída | Teto de tokens que o modelo pode gerar naquela resposta | Achar que toda a janela pode virar resposta |
| Limite de uso | Mensagens, créditos ou uso permitido em determinado período | Confundir com o tamanho de cada resposta |
| Rate limit | Velocidade ou volume permitido na API, como solicitações ou tokens por minuto | Confundir erro de frequência com contexto cheio |
A expressão “limite de tokens” costuma ser usada de forma genérica. Para diagnosticar um problema, identifique qual limite foi atingido: contexto combinado, saída, uso da conta, arquivo, custo ou taxa da API.
O que é um token?
Tokens são blocos de texto processados pelos modelos. Um token pode ser uma palavra inteira, parte de uma palavra, um espaço, um sinal de pontuação ou até um único caractere. Maiúsculas, acentos, posição na frase e contexto podem alterar a divisão.
A explicação oficial da OpenAI sobre tokens oferece aproximações para inglês, como cerca de quatro caracteres ou três quartos de uma palavra por token. Essas são regras de bolso para inglês, não fórmulas universais. Não as aplique como cálculo exato para português, código, JSON, tabelas, nomes próprios, emojis ou conteúdo multimodal.
A tokenização depende do modelo e do encoding. Por isso, dois textos com o mesmo número de palavras podem produzir contagens diferentes, e uma atualização de modelo pode mudar a contagem. Para orçamento ou validação técnica, use as ferramentas de contagem correspondentes ao modelo real.
Por que contar palavras não basta?
- Código possui operadores, espaços, nomes e pontuação próprios.
- JSON e XML adicionam chaves, aspas, nomes de campos e delimitadores.
- Português usa acentos, flexões e palavras compostas diferentes do inglês.
- Tabelas repetem cabeçalhos e separadores.
- Imagens e arquivos possuem regras de processamento que não podem ser estimadas apenas pelos caracteres visíveis.
- A estrutura interna de mensagens acrescenta tokens de função, papéis e limites que não aparecem no texto.
O que conta como tokens de entrada?
Na API, tokens de entrada não são apenas o campo onde o usuário digitou a pergunta. A contagem exata depende da solicitação renderizada para o modelo e pode incluir:
- a mensagem atual do usuário;
- instruções de sistema ou de desenvolvedor;
- mensagens anteriores do usuário e do assistente enviadas como contexto;
- exemplos incluídos no prompt;
- texto extraído ou processado de arquivos;
- imagens, conforme modelo, resolução e configuração;
- definições e schemas de funções, ferramentas ou servidores MCP;
- chamadas e resultados de ferramentas devolvidos ao modelo;
- itens de conversa, compactação e formatação usados para representar a estrutura da requisição.
A documentação oficial de contagem de tokens da Responses API informa que o endpoint aceita texto, mensagens, imagens, arquivos, ferramentas e conversas. Ele também inclui tokens de formatação usados para representar papéis e limites das mensagens, mesmo quando esses tokens não aparecem no texto local.
Definições de funções contam contra a janela de contexto e são cobradas como entrada. Uma lista grande de ferramentas, com descrições e schemas extensos, pode consumir espaço antes que o usuário envie dados úteis. Em integrações complexas, carregue apenas as ferramentas necessárias ou use mecanismos de descoberta quando o modelo oferecer suporte.
O histórico anterior continua contando?
Se mensagens anteriores forem incluídas na solicitação atual, elas ocupam contexto. Na Responses API, usar previous_response_id simplifica o encadeamento, mas não torna o histórico gratuito: a OpenAI informa que os tokens de entrada anteriores da cadeia continuam sendo cobrados como tokens de entrada.
No ChatGPT, conseguir visualizar toda a conversa na tela não prova que cada palavra está presente no contexto ativo de cada nova resposta. O produto pode gerenciar o histórico de formas que dependem do recurso, modelo e interface. Para um detalhe crítico, reenvie a fonte ou mantenha uma síntese validada em vez de confiar na posição antiga no chat.
O que é a janela de contexto?
A janela de contexto é o máximo de tokens que pode ser utilizado em uma única solicitação. Segundo o guia oficial de estado de conversa, esse máximo inclui entrada, saída e tokens de raciocínio quando o modelo os utiliza.
Representação conceitual:
contexto usado ≈ entrada renderizada + tokens gerados

tokens gerados podem incluir:
- raciocínio interno;
- texto visível;
- chamadas de ferramenta;
- tokens internos de formatação.
Essa expressão é conceitual, não uma calculadora universal. A composição exata varia por modelo e endpoint. O valor da janela também não diz quanto texto visível será produzido, porque o modelo pode ter um limite de saída menor e usar parte do orçamento em raciocínio ou estrutura.
Janela maior não significa memória ou precisão perfeitas
Uma janela maior permite enviar mais material, mas não garante que cada detalhe será recuperado, interpretado ou citado corretamente. Conteúdo irrelevante pode reduzir o foco. Para documentos importantes, divida por objetivo, identifique seções, peça referências verificáveis e valide a resposta contra a fonte.
O que é o limite máximo de saída?
O limite máximo de saída é o teto de tokens que o modelo pode gerar em uma resposta. Na Responses API, o desenvolvedor pode definir max_output_tokens. Esse parâmetro estabelece um limite superior; não garante que a resposta usará todo o valor e não substitui o limite próprio do modelo.
Em modelos de raciocínio, max_output_tokens pode incluir tokens de raciocínio, texto visível e tokens não visíveis de formatação. Portanto, definir 2.000 tokens não significa receber 2.000 tokens de texto legível. Se o orçamento for consumido durante o raciocínio, a resposta pode ficar incompleta ou até terminar antes de exibir texto útil.
A documentação de modelos de raciocínio orienta verificar response.status e incomplete_details. Quando o motivo é max_output_tokens, a aplicação deve tratar o resultado como incompleto, não como resposta final válida.
const response = await client.responses.create({
  model: "gpt-5.6",
  input: "Analise os riscos deste plano.",
  max_output_tokens: 1200
});

if (
  response.status === "incomplete" &&
  response.incomplete_details?.reason === "max_output_tokens"
) {
  // Trate como resultado parcial; não publique automaticamente.
}
Em Chat Completions, modelos de raciocínio compatíveis usam max_completion_tokens, enquanto modelos anteriores ou sem raciocínio podem usar max_tokens. Parâmetros e compatibilidade variam por endpoint e modelo; não copie configurações antigas sem consultar a referência atual.
Exemplos numéricos hipotéticos
Atenção: todos os números desta seção são exemplos matemáticos inventados para ensinar o conceito. Eles não representam limites de um modelo, plano ou conta real.
Exemplo hipotético 1: a solicitação cabe
Janela hipotética:                 100.000 tokens
Entrada renderizada:               62.000 tokens
Tokens gerados na resposta:        18.000 tokens
Total efetivamente usado:          80.000 tokens
Espaço não utilizado:              20.000 tokens
Neste exemplo, os 18.000 tokens gerados podem reunir raciocínio, texto e estrutura. Não seria correto interpretar todo esse valor como texto visível.
Exemplo hipotético 2: a janela limita antes do teto de saída
Janela hipotética:                 100.000 tokens
Entrada renderizada:               94.000 tokens
Teto de saída solicitado:          20.000 tokens
Espaço teórico restante:            6.000 tokens
Embora o desenvolvedor tenha solicitado um teto de 20.000, o contexto hipotético deixa somente 6.000 tokens para tudo o que ainda será gerado. A chamada pode ser rejeitada, truncada ou terminar como incompleta, conforme modelo, endpoint e configuração. A solução é reduzir a entrada, dividir a tarefa ou reservar mais espaço.
Exemplo hipotético 3: o limite de saída é menor
Janela hipotética:                 100.000 tokens
Entrada renderizada:               20.000 tokens
Saída máxima hipotética do modelo: 12.000 tokens
Ainda que existam 80.000 tokens de espaço combinado, o modelo deste exemplo não pode gerar mais que seu teto hipotético de 12.000 em uma resposta. Janela disponível e saída máxima são restrições separadas.
Tokens de raciocínio e saída visível
Modelos de raciocínio podem gerar tokens internos antes ou entre partes da resposta e chamadas de ferramenta. Esses tokens não revelam um raciocínio bruto ao usuário, mas ocupam contexto e são contabilizados como saída na API.
O objeto usage pode separar input_tokens, output_tokens, cached_tokens e reasoning_tokens. Mesmo quando reasoning_tokens é zero, a contagem total de saída pode superar os tokens visíveis porque alguns modelos geram delimitadores, chamadas e formatação interna.
- Não estime o tamanho final apenas por
max_output_tokens. - Monitore o uso real por tipo de tarefa.
- Reserve espaço para raciocínio em modelos que o utilizam.
- Trate status incompleto antes de salvar, cobrar ou publicar um resultado.
Tokens em cache também ocupam contexto?
Sim. Tokens em cache são tokens de entrada reutilizados com tratamento de preço e latência específico; eles continuam fazendo parte da entrada e não ampliam a janela do modelo. A documentação de Prompt Caching também informa que cache não altera como o modelo gera a resposta e não elimina rate limits.
Cache não é memória perfeita. Ele reutiliza prefixos elegíveis da solicitação. Alterar instruções, ferramentas ou o início do prompt pode reduzir o reaproveitamento. Consulte a página de preços do modelo porque regras de leitura e escrita de cache podem mudar entre famílias.
Truncamento, descarte e compactação
Quando o conteúdo cresce, diferentes produtos e endpoints podem se comportar de formas diferentes. Dependendo do modelo e da configuração, uma solicitação pode gerar erro, produzir saída incompleta, truncar conteúdo ou usar uma estratégia explícita de gerenciamento de contexto. Não presuma que todas as interfaces descartam automaticamente as mensagens mais antigas da mesma forma.
O que é compactação na Responses API?
A Responses API oferece compactação para conversas longas. Ela reduz o tamanho do contexto e carrega estado anterior relevante em um item opaco para as próximas etapas. Há compactação server-side, ativada com context_management e compact_threshold, e um endpoint separado para controle explícito.
Compactação não é o mesmo que preservar uma transcrição literal completa. A documentação afirma que o item carrega estado essencial usando menos tokens. Por segurança editorial e operacional, mantenha decisões, requisitos e dados críticos em uma estrutura validada e não dependa de detalhes antigos implícitos.
Por que o ChatGPT parece esquecer uma informação?
- O detalhe pode não estar no contexto ativo daquela rodada.
- O histórico pode ter sido reduzido ou representado de outra forma.
- Arquivos podem ser consultados por trechos, não inseridos integralmente em toda resposta.
- A pergunta pode não indicar qual trecho deve ser recuperado.
- O modelo pode interpretar mal a informação mesmo quando ela cabe no contexto.
Não há como confirmar, pela interface pública, qual mecanismo interno causou um caso específico. Reenvie o trecho relevante, indique a fonte e peça que a resposta cite a passagem usada.
Como contar tokens com mais precisão
Para texto simples
O Tokenizer da OpenAI ajuda a visualizar como um texto é dividido. Em código, tiktoken.encoding_for_model(model) pode estimar ou contar texto para um modelo compatível. Ainda assim, uma contagem local de texto puro não representa automaticamente mensagens, imagens, arquivos e schemas de ferramentas.
Para a solicitação real da Responses API
Use o endpoint oficial POST /v1/responses/input_tokens. Ele recebe o mesmo tipo de payload da Responses API e devolve a contagem de entrada que o modelo receberá.
import OpenAI from "openai";

const client = new OpenAI();

const count = await client.responses.inputTokens.count({
  model: "gpt-5.6",
  instructions: "Responda em português brasileiro.",
  input: "Explique janela de contexto em três tópicos."
});

console.log(count.input_tokens);
Para imagens, arquivos e ferramentas, envie ao contador o mesmo payload que pretende usar na geração. Esse método considera a representação específica do modelo, incluindo tokens estruturais difíceis de reproduzir localmente.
Como verificar o limite correto de um modelo
Não copie uma tabela genérica encontrada em blog, vídeo ou resposta antiga. Abra o catálogo oficial de modelos da OpenAI, escolha o ID exato e verifique:
- janela de contexto;
- máximo de tokens de saída;
- snapshot ou alias utilizado;
- modalidades aceitas;
- endpoints compatíveis;
- suporte a raciocínio, ferramentas e Structured Outputs;
- preços de entrada, cache e saída;
- rate limits do tier da organização;
- avisos de depreciação.
ChatGPT e API são produtos diferentes. Um número publicado na página de um modelo da API não deve ser atribuído automaticamente ao ChatGPT. No ChatGPT, verifique a documentação do modelo atual, a página do plano e as configurações do workspace. Por exemplo, a página do GPT-5.6 no ChatGPT separa disponibilidade e limites de uso por plano e modo.
Janela de contexto não é memória, arquivo ou limite de uso
| Conceito | O que controla |
|---|---|
| Janela de contexto | Informação que pode ser processada em uma solicitação |
| Histórico do chat | Conversas armazenadas e exibidas na conta; não garante contexto integral |
| Memória | Personalização entre conversas conforme configurações do produto |
| Upload de arquivo | Tamanho, quantidade e processamento de documentos ou mídia |
| Limite de mensagens | Quantidade de interações permitidas em determinado período |
| Rate limit da API | Solicitações e tokens permitidos por unidade de tempo ou fila |
| Limite de gastos | Valor que projeto ou organização pode consumir |
Uma mensagem de “limite atingido” pode se referir a qualquer uma dessas categorias. Leia o código, o status ou a mensagem completa antes de concluir que faltou contexto.
Por que uma resposta pode parar ou ser cortada?
- o modelo atingiu o máximo de saída;
- entrada, raciocínio e saída excederam o contexto disponível;
- o desenvolvedor configurou um teto baixo em
max_output_tokens; - a aplicação tratou incorretamente streaming ou uma resposta incompleta;
- houve falha de rede, timeout ou interrupção do navegador;
- uma ferramenta retornou conteúdo excessivo ou falhou;
- uma regra de segurança ou produto alterou a resposta.
Nem toda resposta curta é um problema de tokens. Antes de mandar “continue”, verifique se o resultado terminou em frase completa, se a interface mostrou erro e, na API, se o status foi completed ou incomplete.
Boas práticas para usuários do ChatGPT
- Defina o objetivo antes de anexar ou colar material extenso.
- Peça um índice e escreva trabalhos longos por seções.
- Forneça novamente fatos críticos ao mudar de etapa.
- Crie uma síntese validada de decisões, fontes e restrições.
- Peça citações de página ou trecho ao analisar documentos importantes.
- Evite exigir um livro, relatório e revisão completa na mesma resposta.
- Salve versões intermediárias fora da conversa.
- Não interprete memória ou histórico visível como garantia de contexto integral.
Boas práticas para desenvolvedores
- Conte o payload real com
/v1/responses/input_tokens. - Valide o modelo e snapshot na inicialização da aplicação.
- Reserve margem para saída, raciocínio e chamadas de ferramenta.
- Monitore
input_tokens,cached_tokens,output_tokensereasoning_tokens. - Trate explicitamente status incompleto, timeouts e falhas de ferramenta.
- Reduza schemas e não carregue ferramentas irrelevantes em toda chamada.
- Recupere apenas trechos pertinentes de bases extensas.
- Use compactação ou sumarização controlada em conversas longas.
- Mantenha fatos críticos em estado estruturado, não apenas no texto do chat.
- Execute testes quando trocar alias, snapshot, modelo ou endpoint.
Perguntas frequentes
Um token é igual a uma palavra?
Não. Um token pode ser parte de uma palavra, uma palavra inteira, pontuação, espaço ou caractere. A divisão depende do modelo, encoding, idioma e contexto.
Qual é o limite de tokens do ChatGPT?
Não existe um número único. O limite depende do modelo, plano, modo, ferramenta e configuração do workspace. Consulte a página oficial do modelo e do plano utilizados.
A janela de contexto inclui a resposta?
Sim. A documentação da API define contexto como o máximo combinado de entrada, saída e, quando aplicável, tokens de raciocínio.
O limite de saída é igual à janela de contexto?
Não. Um modelo pode aceitar uma entrada grande e ainda ter um teto de saída menor. Os dois limites precisam ser verificados separadamente.
max_output_tokens corresponde ao texto visível?
Não necessariamente. Em modelos de raciocínio, o parâmetro limita o total gerado, que pode incluir raciocínio e formatação não visíveis além do texto apresentado.
Tokens em cache deixam de ocupar contexto?
Não. Eles continuam sendo entrada. O cache pode alterar preço e latência, mas não amplia a janela e não elimina rate limits.
previous_response_id elimina a contagem do histórico?
Não. Ele simplifica o encadeamento, mas a OpenAI informa que os tokens anteriores da cadeia continuam sendo cobrados como entrada.
Como saber quantos tokens uma solicitação real usará?
Na Responses API, envie o mesmo payload ao endpoint /v1/responses/input_tokens. Para explorar texto simples, use o Tokenizer ou uma biblioteca compatível com o modelo.
Uma conversa longa perde sempre as mensagens mais antigas?
Não é seguro generalizar. O comportamento depende do produto, endpoint e configuração. Pode haver erro, truncamento, seleção, resumo ou compactação. Reenvie informações críticas em vez de presumir o mecanismo utilizado.
Um arquivo inteiro entra na janela de contexto?
Não necessariamente. O processamento depende do produto, modelo, ferramenta e tipo de arquivo. O sistema pode extrair, converter ou recuperar somente partes relevantes.
Nota editorial: este guia evita publicar números universais de contexto ou saída. Para qualquer modelo específico, confira o catálogo oficial, a página do ID exato e a documentação do produto na data da implementação.