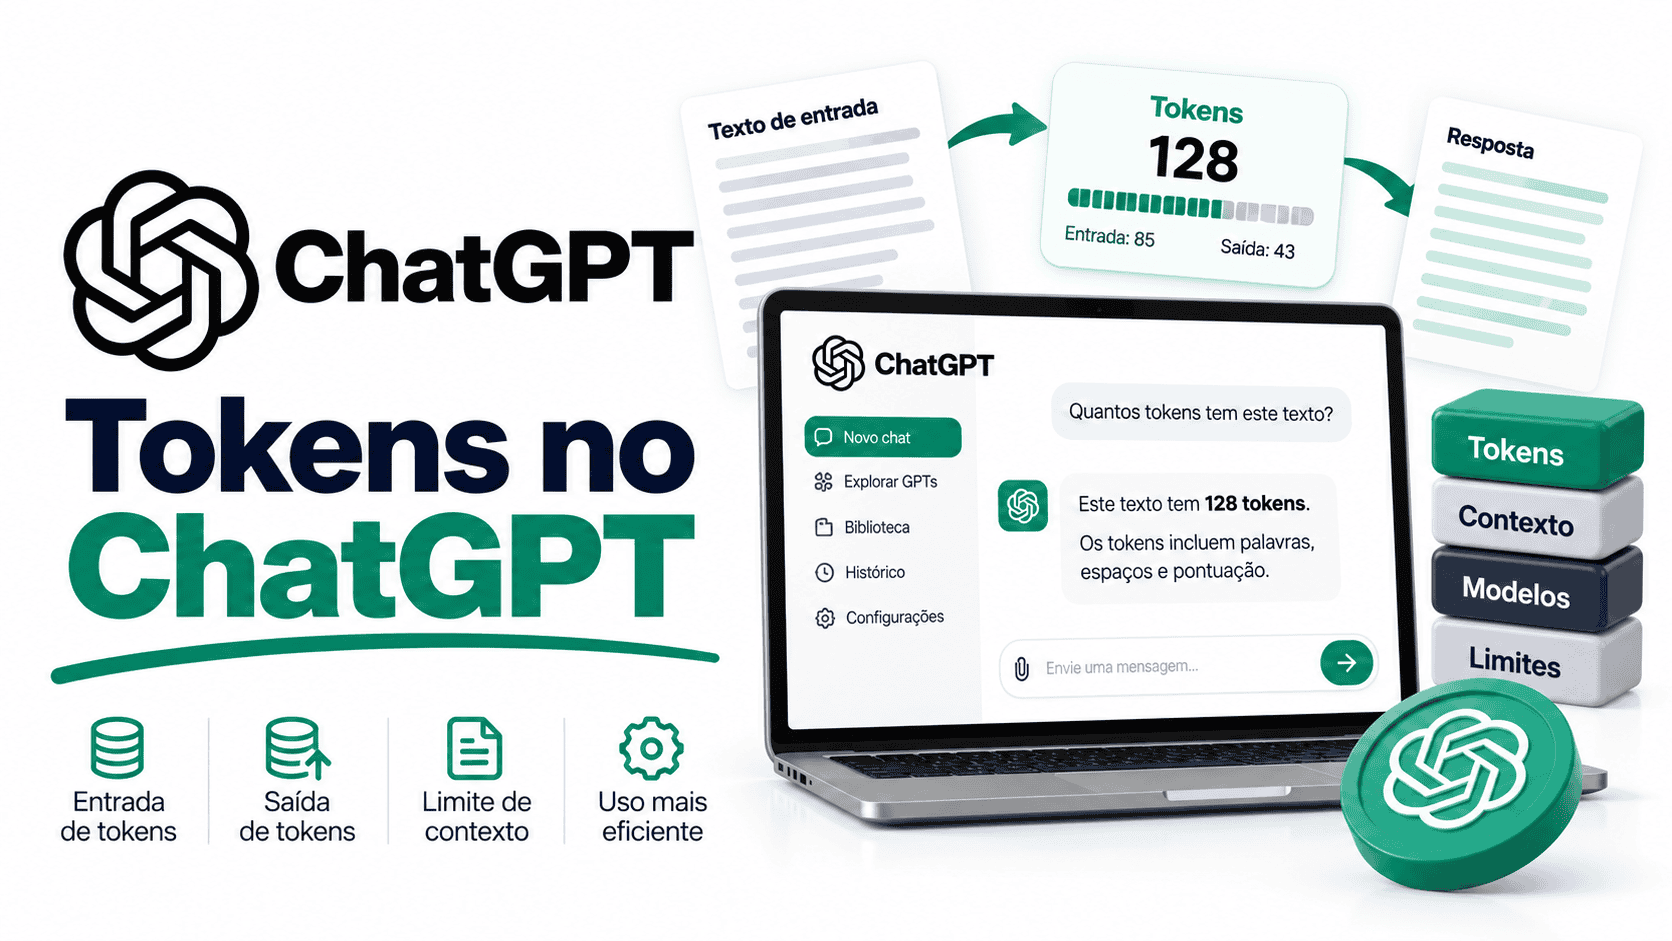

Tokens no ChatGPT são as unidades em que o texto é dividido para que o modelo possa processar sua solicitação e gerar uma resposta. Um token pode ser um caractere, parte de uma palavra, uma palavra inteira ou um sinal de pontuação. Por isso, contar palavras não fornece uma contagem exata de tokens.
Os tokens importam porque ajudam a definir quanto conteúdo cabe na janela de contexto, qual pode ser o tamanho da resposta, como arquivos e conversas longas são processados e quanto uma chamada à OpenAI API pode custar. Eles não devem ser confundidos com mensagens, créditos, memória ou histórico de chats.
Token é a unidade processada pelo modelo; janela de contexto é o espaço total disponível na interação; o plano ou a API determina como o uso é limitado ou cobrado.
Documentação e limites verificados em 12 de outubro de 2026. Modelos, janelas de contexto, planos, créditos e regras de uso podem mudar.
O que são tokens no ChatGPT?
A documentação oficial da OpenAI sobre tokens define token como um bloco básico de texto processado pelo modelo.
Dependendo do idioma, do contexto e da codificação usada pelo modelo, um token pode representar:
- uma palavra curta e frequente;
- uma parte de uma palavra;
- um único caractere;
- um número;
- um espaço junto de uma palavra;
- uma vírgula, ponto ou outro sinal;
- parte de um trecho de código ou marcação.
O processo de dividir o conteúdo em tokens é chamado de tokenização. O componente que executa essa divisão é o tokenizer.
Depois da tokenização, o modelo trabalha com identificadores numéricos, processa os padrões associados a eles e gera novos tokens. No final, esses tokens são convertidos novamente em texto legível.
Token não é sinônimo de palavra
Uma palavra pode ocupar um token, vários tokens ou uma combinação diferente conforme sua posição na frase. Espaços e letras maiúsculas também podem mudar a divisão.
Por exemplo, uma palavra no começo da frase pode ser representada de forma diferente da mesma palavra precedida por um espaço. Termos pouco frequentes, nomes próprios, URLs, sequências numéricas, código e palavras compostas também podem ser divididos em mais partes.
Isso explica por que duas frases com o mesmo número de palavras podem consumir quantidades diferentes de tokens.
Token, palavra, mensagem e crédito: qual é a diferença?
| Termo | O que significa | O que não significa |
|---|---|---|
| Token | Unidade de texto processada ou gerada pelo modelo | Não equivale sempre a uma palavra |
| Palavra | Unidade linguística percebida pelo leitor | Não é a unidade técnica usada para os limites |
| Caractere | Letra, número, espaço ou sinal | Não equivale sempre a um token |
| Mensagem | Uma solicitação ou resposta dentro do ChatGPT | Pode conter poucos ou muitos tokens |
| Crédito | Unidade de uso ou cobrança adotada por determinados recursos e planos | Nem sempre corresponde a um token |
| Janela de contexto | Quantidade total de tokens que pode participar de uma interação | Não é uma memória permanente |
| Limite de saída | Máximo que o modelo pode gerar em uma resposta | Não é o total da janela de contexto |
| Limite de mensagens | Quantidade de mensagens permitidas em determinado período | Não é um limite direto de palavras ou tokens |
| Rate limit | Velocidade permitida de uso da API | Não é o orçamento mensal |
| Limite de arquivo | Tamanho ou quantidade permitida para upload | Não garante que todo o arquivo entre no contexto ao mesmo tempo |
Essa separação evita um erro comum: chamar qualquer aviso de uso do ChatGPT de “limite de tokens”. O usuário pode ter atingido um limite de mensagens, uma cota de ferramenta, um limite de arquivo, um saldo de créditos ou uma restrição temporária do modelo.
Quais tipos de tokens existem?
Tokens de entrada
São os tokens fornecidos ao modelo antes da resposta. Também podem ser chamados de tokens do prompt.
A entrada pode incluir mais que a última mensagem digitada pelo usuário:
- instruções do sistema e da aplicação;
- mensagens anteriores incluídas no contexto;
- sua solicitação atual;
- trechos recuperados de arquivos;
- resultados de pesquisa;
- descrições de ferramentas;
- esquemas de saída estruturada;
- representações de imagens e outras modalidades.
Por isso, contar somente o texto visível que você colou pode produzir um valor menor que a entrada total processada por uma aplicação.
Tokens de saída
São os tokens gerados pelo modelo. Eles formam a resposta, os argumentos de uma chamada de ferramenta ou uma saída estruturada, conforme o fluxo utilizado.
Uma solicitação como “explique detalhadamente e dê 30 exemplos” tende a reservar ou consumir mais saída que um pedido de resumo em cinco tópicos.
Tokens de entrada em cache
São partes reutilizadas de uma entrada anterior ou de um prefixo repetido que atendem às condições do sistema de cache. Na OpenAI API e em alguns modelos de cobrança do ChatGPT, eles podem ter uma tarifa menor que a entrada comum.
Cache não é o mesmo que Memória do ChatGPT. O cache está ligado ao reaproveitamento computacional de uma entrada; a Memória está ligada à personalização entre conversas.
Tokens de raciocínio
Alguns modelos usam tokens internos adicionais para planejar ou raciocinar antes de produzir a resposta final. Esses tokens não aparecem integralmente como texto para o usuário.
Uma resposta curta pode, portanto, ter exigido mais processamento que seu tamanho visível sugere. Na API, as informações de uso e as regras de cobrança dependem do modelo e do endpoint.
Tokens de imagens, áudio e arquivos
Não estime entradas multimodais dividindo caracteres por quatro. Imagens, áudio, arquivos, ferramentas e mensagens estruturadas possuem formas próprias de representação e cobrança, que variam conforme o modelo.
Para um pedido completo da Responses API, a OpenAI recomenda a API de contagem de tokens de entrada, que aceita texto, mensagens, imagens, arquivos, ferramentas e conversas.
O que é a janela de contexto?
A janela de contexto é o limite de tokens que o modelo pode usar em uma interação. Ela não representa apenas a última pergunta.
contexto total =
instruções
+ histórico incluído
+ mensagem atual
+ trechos recuperados
+ arquivos e ferramentas
+ raciocínio, quando aplicável
+ espaço reservado para a saída
Essa é uma representação conceitual. A composição exata varia conforme o produto, o modelo e as ferramentas utilizadas.
A documentação da OpenAI sobre estado de conversação explica que a janela inclui entrada, saída e, em determinados modelos, tokens de raciocínio.
Não existe um único limite de tokens para todo o ChatGPT
O limite pode mudar conforme:
- modelo;
- modo de raciocínio;
- plano;
- workspace;
- ChatGPT, Work, Codex ou API;
- tipo de tarefa;
- ferramentas e arquivos utilizados.
Em uma nota de versão publicada em 20 de fevereiro de 2026, a OpenAI informou uma janela total de 256 mil tokens para o modo Thinking selecionado manualmente: 128 mil de entrada e até 128 mil de saída.
Esse número é específico da configuração descrita na nota. Ele não deve ser aplicado automaticamente a conversas Instant, contas Free ou Go, modelos Pro, GPTs, Projects, Codex, ChatGPT Work ou modelos da API.
Consulte a página atual de modelos e limites do ChatGPT e, para a API, a página do model ID realmente utilizado.
Mais contexto não garante melhor resposta
Uma janela maior permite fornecer mais material, mas o modelo ainda pode:
- não localizar uma exceção pouco destacada;
- confundir versões do mesmo documento;
- dar prioridade a uma instrução mais recente;
- interpretar um termo de forma errada;
- resumir demais uma seção;
- produzir uma resposta incompleta.
Organização, fonte, versão e instruções claras continuam importantes mesmo quando o contexto disponível é grande.
Por que o ChatGPT pode esquecer o começo da conversa?
“Esquecer” nem sempre significa que o chat foi apagado. Em uma conversa longa, o contexto efetivamente utilizado pode não manter todos os detalhes com a mesma prioridade.
As causas possíveis incluem:
- muitas mensagens e arquivos acumulados;
- instruções antigas e novas em conflito;
- mudança de objetivo durante o chat;
- uso de uma versão desatualizada do arquivo;
- trecho relevante não recuperado;
- novo chat iniciado sem um resumo de transição;
- mudança de modelo, modo ou Project.
Crie um checkpoint em vez de repetir toda a conversa
Crie um checkpoint verificado desta conversa.

Use apenas o que foi confirmado no chat.

Separe:
1. objetivo atual;
2. decisões aprovadas;
3. restrições obrigatórias;
4. itens rejeitados;
5. fontes e arquivos vigentes;
6. tarefas concluídas;
7. pendências;
8. informações que ainda precisam de confirmação;
9. próxima etapa.

Não acrescente suposições.
Marque conflitos entre versões.
Espere minha confirmação antes de usar o checkpoint como referência.
Depois de revisar o checkpoint, use-o como contexto atualizado. Se a conversa ficou confusa, inicie um novo chat e cole o resumo aprovado em vez de transportar uma transcrição inteira.
Janela de contexto, saída e mensagens são limites diferentes
| Limite | O que mede | O que pode acontecer | Resposta adequada |
|---|---|---|---|
| Janela de contexto | Entrada, saída e outros tokens incluídos na interação | Parte do conteúdo pode não caber ou a solicitação pode falhar | Reduzir, dividir ou recuperar somente trechos relevantes |
| Saída máxima | Quantidade que o modelo pode gerar | A resposta pode terminar antes do esperado | Dividir o entregável ou continuar de um ponto preciso |
| Mensagens | Quantidade permitida por período, modelo ou plano | O modelo fica temporariamente indisponível ou usa fallback | Aguardar o reset ou escolher outra opção disponível |
| Rate limit da API | Solicitações ou tokens processados por período | Erro de limite, como uma resposta 429 | Controlar concorrência, fila e tentativas |
| Gasto | Orçamento ou saldo permitido | Novas chamadas podem ser bloqueadas | Ajustar orçamento, modelo ou volume |
| Arquivo | Tamanho, tokens ou quantidade permitida no upload | O arquivo é recusado | Reduzir, dividir ou converter o arquivo |
| Armazenamento | Espaço disponível para arquivos salvos | Novos arquivos não podem ser guardados | Excluir itens desnecessários ou revisar o plano |
| Ferramenta | Cota de pesquisa, imagem, voz ou análise | O recurso específico fica indisponível | Aguardar o reset ou usar outro fluxo |
Leia a mensagem de erro ou o aviso exibido. Não presuma que qualquer bloqueio significa falta de tokens.
Quantas palavras correspondem a um token?
A OpenAI fornece as seguintes estimativas aproximadas para texto em inglês:
- um token corresponde a cerca de quatro caracteres;
- um token corresponde a aproximadamente três quartos de uma palavra;
- 100 tokens correspondem a aproximadamente 75 palavras.
Esses valores são atalhos para estimativas, não fórmulas. A própria documentação limita os exemplos ao inglês e alerta que outros idiomas podem produzir relações diferentes.
Existe uma conversão fixa para português?
Não. Não existe uma regra oficial universal dizendo que uma palavra em português corresponde a uma quantidade fixa de tokens ou que o português sempre consome uma porcentagem específica a mais que o inglês.
A contagem pode ser afetada por:
- palavras flexionadas;
- acentos;
- nomes próprios;
- abreviações;
- espaços;
- pontuação;
- capitalização;
- URLs;
- código e marcação;
- modelo e encoding utilizados.
Para conteúdo em português do Brasil, meça o texto real. Não traduza automaticamente o prompt para inglês apenas para reduzir tokens: a economia pode não compensar perda de precisão, tom ou terminologia.
Como contar tokens de um texto
1. Use o Tokenizer oficial para texto simples
A ferramenta Tokenizer da OpenAI mostra como um texto é dividido e quantos tokens ele contém segundo a codificação selecionada.
- Abra o Tokenizer.
- Cole o texto.
- Selecione a codificação ou o modelo adequado, quando a opção estiver disponível.
- Registre qual codificação foi usada.
- Não compare contagens feitas com encodings diferentes como se fossem equivalentes.
2. Use tiktoken para uma contagem local
Desenvolvedores podem usar a biblioteca tiktoken. O método deve selecionar a codificação compatível com o model ID pretendido.
Essa abordagem é útil para texto simples. Ela não reproduz necessariamente toda a entrada enviada por uma aplicação que inclui funções, ferramentas, imagens, arquivos, papéis de mensagem ou esquemas.
3. Conte o pedido completo da Responses API
Para uma contagem precisa antes da chamada, use o endpoint oficial de contagem de entrada da Responses API.
Ele considera formatos aceitos pela Responses API, como:
- mensagens;
- imagens;
- arquivos;
- ferramentas;
- conversas;
- tokens de formatação da estrutura do pedido.
A contagem da entrada não prevê o tamanho da resposta. Reserve espaço para a saída e, quando aplicável, para raciocínio.
4. Confira o uso real depois da chamada
Os endpoints retornam dados de uso. Os nomes dos campos dependem da API:
| Endpoint | Campos comuns |
|---|---|
| Responses API | input_tokens, output_tokens e total_tokens |
| Chat Completions | prompt_tokens, completion_tokens e total_tokens |
O painel de uso e os metadados das respostas da API ajudam a comparar a estimativa com o consumo real.
É possível pedir ao ChatGPT que conte os próprios tokens?
O ChatGPT pode estimar o tamanho do texto visível, mas essa resposta não deve ser tratada como a contagem completa do contexto.
Ele pode não ter acesso a todos os componentes que entram na solicitação, como instruções do sistema, conteúdo recuperado, definições de ferramentas ou representação de arquivos e imagens.
Use o Tokenizer para texto simples e a API de contagem para um pedido completo.
ChatGPT cobra por token?
A resposta depende do produto, do plano e do recurso.
Planos pessoais do ChatGPT
Em uma conta pessoal, o uso comum do chat faz parte do plano e pode estar sujeito a limites de mensagens, modelos ou ferramentas. O usuário não deve presumir que cada resposta comum gera uma cobrança separada semelhante à API.
A página O que é ChatGPT Plus deixa claro que a assinatura do ChatGPT e o uso da OpenAI API são cobrados separadamente.
Créditos de uso flexível
Algumas contas podem comprar créditos para continuar usando recursos compatíveis após atingir o limite incluído. A disponibilidade varia por conta, plano, região e recurso.
A documentação atual de créditos para uso flexível cita recursos como Codex, ChatGPT Work e ferramentas de documentos e planilhas, quando disponíveis.
Esses créditos não são créditos da OpenAI API.
Workspaces empresariais
Determinados contratos Business, Enterprise ou Edu podem medir atividades por mensagem, tarefa, crédito ou milhão de tokens. A modalidade aplicável depende do contrato e do recurso.
Não use a tabela de preços Enterprise baseada em tokens para calcular o custo de uma conta pessoal sem confirmar que ela se aplica ao seu caso.
OpenAI API
A API possui faturamento separado. A tarifa depende do modelo, da categoria de token e das ferramentas utilizadas.
custo de texto =
(tokens de entrada ÷ 1.000.000 × tarifa de entrada)
+ (tokens em cache ÷ 1.000.000 × tarifa de cache)
+ (tokens de saída ÷ 1.000.000 × tarifa de saída)
+ cobranças de ferramentas aplicáveis
Consulte a página atual de preços da OpenAI API e a página do modelo específico. Não calcule o custo usando um preço encontrado em tutorial antigo.
Por que a saída costuma custar mais na API?
Em muitos modelos, a tarifa dos tokens de saída é maior que a de entrada. A geração sequencial da resposta exige processamento diferente da leitura do prompt.
Isso significa que uma aplicação pode reduzir custo não apenas encurtando o prompt, mas também controlando respostas excessivamente longas.
- Peça somente os campos necessários.
- Use formato estruturado quando isso simplificar o consumo.
- Não peça várias versões se usará apenas uma.
- Evite explicações repetidas.
- Monitore retries e chamadas duplicadas.
Uma tarifa menor por milhão não garante o menor custo total. Modelos diferentes podem usar quantidades distintas de entrada, raciocínio, ferramentas e saída para concluir a mesma tarefa.
O limite de arquivo é um limite de contexto?
Não. Um arquivo pode ser aceito pelo produto sem que todo o seu conteúdo seja colocado simultaneamente na janela de contexto.
A página de armazenamento de arquivos e Library informa atualmente:
- até 512 MB por arquivo;
- até dois milhões de tokens por arquivo de texto ou documento;
- uma regra diferente para planilhas;
- limites próprios para imagens e armazenamento.
O limite de dois milhões de tokens indica se um documento pode ser aceito. Ele não significa que dois milhões de tokens estarão ativos em uma única resposta.
Em uma página específica para Enterprise, a OpenAI explica que parte do conteúdo pode ser inserida diretamente, enquanto o restante é colocado em um índice privado para recuperação de trechos relevantes. Esse comportamento não deve ser generalizado para todos os planos sem consultar a documentação correspondente.
Como analisar um documento longo sem presumir cobertura total
Antes de resumir o documento, faça uma auditoria de cobertura.

1. Informe o título, a quantidade de páginas detectada e as seções encontradas.
2. Liste páginas ou trechos ilegíveis.
3. Identifique tabelas, imagens, anexos e notas que podem não ter sido interpretados.
4. Crie um mapa das seções.
5. Não produza ainda o resumo final.
6. Para cada afirmação posterior, cite a página ou seção.
7. Marque [NÃO LOCALIZADO] quando a informação não aparecer.
8. Ao final, liste quais seções foram e não foram usadas.
Depois da auditoria, trabalhe por seção e compare o resumo final com o arquivo original.
Como economizar tokens sem perder qualidade
| Ação | Benefício | Risco se for exagerada |
|---|---|---|
| Remover repetições | Reduz entrada sem perder fatos | Baixo, se o texto duplicado for realmente idêntico |
| Manter somente a versão vigente | Evita conflito e economiza contexto | Perder histórico necessário para comparação |
| Usar checkpoint | Substitui uma transcrição extensa por um resumo validado | O resumo pode omitir uma exceção |
| Definir formato da saída | Evita respostas longas e dispersas | Formato rígido demais pode ocultar nuance |
| Dividir a tarefa | Facilita revisão e reduz contexto por etapa | As partes podem perder conexão se não houver handoff |
| Recuperar somente trechos relevantes | Escala para bases grandes | O mecanismo pode não recuperar uma passagem crítica |
| Usar cache na API | Reduz custo de prefixos repetidos elegíveis | Não resolve conteúdo mutável ou mal estruturado |
| Escolher outro modelo após testes | Pode reduzir custo ou latência | Qualidade pode cair na tarefa real |
| Limitar a saída | Controla custo e evita texto desnecessário | A resposta pode ficar incompleta |
Não remova definições, fontes, critérios de qualidade, restrições de segurança ou campos obrigatórios apenas para economizar tokens.
O objetivo não é usar o menor número possível de tokens, mas fornecer contexto suficiente para concluir a tarefa com qualidade e custo controlado.
Prompt para reduzir contexto com segurança
Reduza o texto abaixo sem remover requisitos importantes.

Separe o resultado em:
1. objetivo;
2. fatos;
3. restrições;
4. formato de saída;
5. fontes;
6. critérios de validação;
7. informações proibidas;
8. pontos ainda incertos.

Remova:
- repetição;
- exemplos redundantes;
- comentários sem efeito na tarefa;
- versões substituídas.

Não remova:
- números;
- datas;
- exceções;
- requisitos de segurança;
- decisões aprovadas;
- referências.

Depois, apresente:
- itens removidos;
- itens preservados;
- riscos de perda de contexto.
Prompt curto é sempre melhor?
Não. Um prompt curto pode economizar entrada, mas também pode deixar o modelo sem objetivo, fonte, público, restrições ou formato.
Compare:
Prompt insuficiente:
Resuma este relatório.

Prompt estruturado:
Resuma o relatório para a diretoria.
Use somente o arquivo anexado.
Separe fatos, riscos, decisões e pendências.
Cite a seção de origem.
Não invente números.
Limite o resumo a 600 palavras.
O segundo prompt usa mais tokens, mas pode reduzir retrabalho, correções e respostas adicionais. A eficiência deve ser medida por tarefa concluída, não apenas por prompt mais curto.
Exemplo: relatório longo e conversa extensa
Considere uma pessoa que possui um relatório extenso, discutiu várias versões em uma conversa longa e precisa produzir um resumo executivo de duas páginas.
Fluxo pouco confiável
- Anexar versões antigas e atuais sem identificação.
- Colar novamente toda a conversa.
- Pedir “resuma tudo”.
- Presumir que toda página foi considerada.
- Publicar a primeira resposta.
Fluxo mais seguro
- Remover versões substituídas.
- Nomear o arquivo vigente.
- Criar um checkpoint das decisões.
- Mapear as seções do relatório.
- Extrair fatos e evidências por seção.
- Definir o público e o limite da saída.
- Gerar o resumo.
- Auditar páginas, números, exceções e omissões.
Esse fluxo pode usar mais de uma solicitação, mas reduz o risco de gastar contexto com material duplicado e produzir um resumo incompleto.
Como estimar um orçamento de tokens para a API
Antes de projetar custo, defina a unidade de trabalho. Uma “conversa” pode possuir várias chamadas, ferramentas, retries e etapas internas.
Ajude-me a montar um orçamento de tokens para esta aplicação.

Dados:
- model ID: [modelo];
- solicitações por dia: [quantidade];
- tokens médios de entrada: [quantidade medida];
- tokens médios de entrada em cache: [quantidade medida];
- tokens médios de saída: [quantidade medida];
- ferramentas por solicitação: [lista e frequência];
- retries médios: [quantidade];
- dias por mês: [quantidade].

Entregue:
1. fórmula;
2. custo por solicitação;
3. custo diário;
4. custo mensal;
5. cenário mínimo, esperado e máximo;
6. variáveis não medidas;
7. sugestões de teste.

Use apenas as tarifas oficiais atuais do model ID informado.
Informe a data e o link da tabela.
Não invente uso de cache.
Não presuma que toda entrada será elegível ao cache.
Faça a estimativa com dados medidos em chamadas representativas. Um protótipo de duas mensagens não representa necessariamente um agente que pesquisa, lê arquivos, chama ferramentas e corrige a própria saída.
Problemas comuns relacionados a tokens
A resposta parou no meio
A causa pode ser limite de saída, interrupção de ferramenta, timeout ou tarefa grande demais para uma única resposta.
- Peça para continuar a partir do último título completo.
- Não solicite a repetição de todo o conteúdo.
- Divida o entregável em partes verificáveis.
- Na API, confira o motivo de término e o limite de saída do modelo.
O ChatGPT ignorou uma instrução antiga
Crie um checkpoint atualizado, destaque a regra vigente e elimine instruções conflitantes. Quando necessário, abra um novo chat com um handoff revisado.
O arquivo foi aceito, mas uma seção não apareceu
Peça primeiro um inventário do documento. Depois, consulte a seção, o título ou a página diretamente e solicite uma auditoria de cobertura.
A API informou que o contexto é grande demais
- Conte o pedido completo.
- Reserve espaço para saída e raciocínio.
- Remova mensagens duplicadas.
- Use recuperação de trechos.
- Divida documentos.
- Avalie compaction quando for compatível.
- Selecione outro modelo somente após confirmar limites e qualidade.
O custo ficou acima da estimativa
Revise:
- comprimento da saída;
- tokens de raciocínio;
- contexto repetido;
- cache realmente aplicado;
- ferramentas;
- imagens e arquivos;
- retries;
- chamadas delegadas;
- modelo utilizado;
- tarifa de contexto longo;
- solicitações duplicadas.
A estimativa e o uso real não coincidem
As diferenças podem vir de encoding, formatação das mensagens, ferramentas, esquemas, mídia, arquivos, tokens de raciocínio, múltiplas chamadas ou contagem local incompleta.
Checklist para trabalhar com tokens
- Identifique se está usando ChatGPT ou OpenAI API.
- Confirme o modelo e a superfície.
- Verifique a janela de contexto atual.
- Verifique o limite de saída.
- Não aplique estimativas do inglês ao português como contagem exata.
- Use Tokenizer para texto simples.
- Use a API de contagem para pedidos completos.
- Leia os dados de uso após a chamada.
- Separe limites de mensagens, ferramentas, arquivos e tokens.
- Reserve espaço para a resposta.
- Crie checkpoints em conversas longas.
- Não presuma que um arquivo aceito foi lido por inteiro.
- Monitore retries e ferramentas.
- Confirme se o cache foi aplicado.
- Use preços e limites da documentação atual.
Perguntas frequentes
Um token equivale a quantas palavras?
Não existe uma equivalência exata. Para inglês, a OpenAI usa como aproximação um token para três quartos de uma palavra. Em português, use o Tokenizer para medir o texto real.
Espaços e pontuação contam como tokens?
Eles afetam a tokenização. Um espaço pode fazer parte do token associado à palavra seguinte, e sinais de pontuação podem formar tokens próprios.
Maiúsculas e acentos mudam a contagem?
Podem mudar. A divisão depende da sequência exata de caracteres e da codificação usada pelo modelo.
Código costuma usar muitos tokens?
Pode usar, especialmente quando contém identificadores longos, JSON repetitivo, logs, espaços, símbolos e marcação. Conte o conteúdo real em vez de aplicar uma média de prosa.
Quantos tokens o ChatGPT aceita?
Não existe um único número. O limite depende do modelo, modo, plano, workspace e produto. Verifique a documentação atual da configuração utilizada.
O contexto de 256 mil tokens vale para todos?
Não. O número foi publicado para o modo Thinking selecionado manualmente em uma configuração específica. Não o transfira para outros modelos, planos ou superfícies.
Um arquivo com dois milhões de tokens é lido inteiro em uma resposta?
Não necessariamente. O limite indica que o arquivo pode ser aceito. O sistema pode inserir parte do conteúdo e recuperar trechos relevantes, conforme o produto e o plano.
Limite de mensagens é limite de tokens?
Não. Uma mensagem pode ser curta ou longa. O limite de mensagens controla uso por período, enquanto a janela de contexto controla o conteúdo de uma interação.
ChatGPT Plus inclui tokens da API?
Não. A assinatura do ChatGPT e a OpenAI API possuem cobrança e uso separados.
Créditos comprados no ChatGPT funcionam na API?
Não segundo a documentação atual de uso flexível. Os créditos compatíveis com recursos do ChatGPT não são créditos da API.
Memória aumenta a janela de contexto?
Não deve ser entendida dessa forma. A Memória fornece personalização relevante, mas não transforma todo o histórico em contexto ilimitado.
Projects oferecem contexto infinito?
Não. Projects organizam chats, arquivos e instruções, mas as respostas continuam sujeitas aos limites e mecanismos do modelo e do produto.
Excluir um chat recupera tokens?
Não existe um saldo de tokens da conversa que seja devolvido ao excluir o chat. A exclusão afeta armazenamento e retenção; os limites de uso seguem as regras do plano ou da API.
Um prompt menor é sempre mais barato?
Na API, menos entrada pode reduzir custo, mas um prompt incompleto pode gerar respostas ruins, retries e saídas maiores. Meça o custo da tarefa concluída.
Regra prática
Use estimativas apenas para planejamento rápido. Para texto simples, conte com o Tokenizer. Para uma entrada completa da Responses API, use o endpoint de contagem. Depois da chamada, confira os metadados reais de uso.
Em conversas longas, preserve decisões e restrições em checkpoints. Em documentos extensos, trabalhe por seções e audite a cobertura. Na API, monitore entrada, cache, saída, raciocínio, ferramentas e retries.
Tokens são uma medida técnica importante, mas não devem ser o único critério. Uma solicitação eficiente é aquela que usa contexto suficiente, produz uma resposta verificável e conclui a tarefa sem retrabalho desnecessário.
Fontes oficiais verificadas
- O que são tokens e como contá-los
- Tokenizer da OpenAI
- Conceitos fundamentais da OpenAI API
- Contagem de tokens de entrada na Responses API
- Estado de conversa e janela de contexto
- Notas de versão do ChatGPT
- Modelos e limites atuais do ChatGPT
- Armazenamento de arquivos e Library no ChatGPT
- Processamento de arquivos no ChatGPT Enterprise
- O que é ChatGPT Plus
- Créditos para uso flexível em planos pessoais
- Tabela de preços Enterprise baseada em tokens
- Tabela de créditos Business, Enterprise e Edu
- Preços atuais da OpenAI API
- Catálogo de modelos da OpenAI API
- Como verificar o uso de tokens da API